A varredura em 8 zonas: o que a sua foto revela sobre você antes de publicar
Quem procura saber o que a sua foto revela sobre você costuma encontrar susto: o reflexo no olho que mostraria quem está na sua frente, o fundo que entregaria o endereço, a inteligência artificial que descobriria a rua. Nas sete páginas que medi em 11/08/2026 sobre esse assunto, 13.437 palavras somadas, não aparece um único pixel, nenhum limiar e nenhum estudo nomeado. Aqui a ordem é outra: primeiro o procedimento, depois a conta que ordena o procedimento.
Uma foto de perfil tem oito zonas que carregam informação além do rosto, e elas não valem a mesma coisa. A distância entre a primeira e a última passa de uma ordem de grandeza em pixels, e é isso que decide por onde começar a olhar. A varredura abaixo é feita no arquivo original, na primeira pessoa, sobre a sua própria foto, antes de ela subir.
Antes da lista, o zoom certo. Abra a foto no tamanho original, não a miniatura da galeria, e amplie até a largura do seu rosto ocupar a tela inteira. Esse é o zoom da varredura. A regra de bolso que calibra o resto: o diâmetro da íris tem cerca de 8% da largura do rosto. Se, nesse zoom, a íris aparece com menos de 80 px de diâmetro, o rosto que caberia refletido nela fica abaixo dos 7 x 10 px que o próprio estudo do reflexo cita como piso para reconhecer um rosto já familiar, e a oitava zona se resolve antes de você chegar nela.
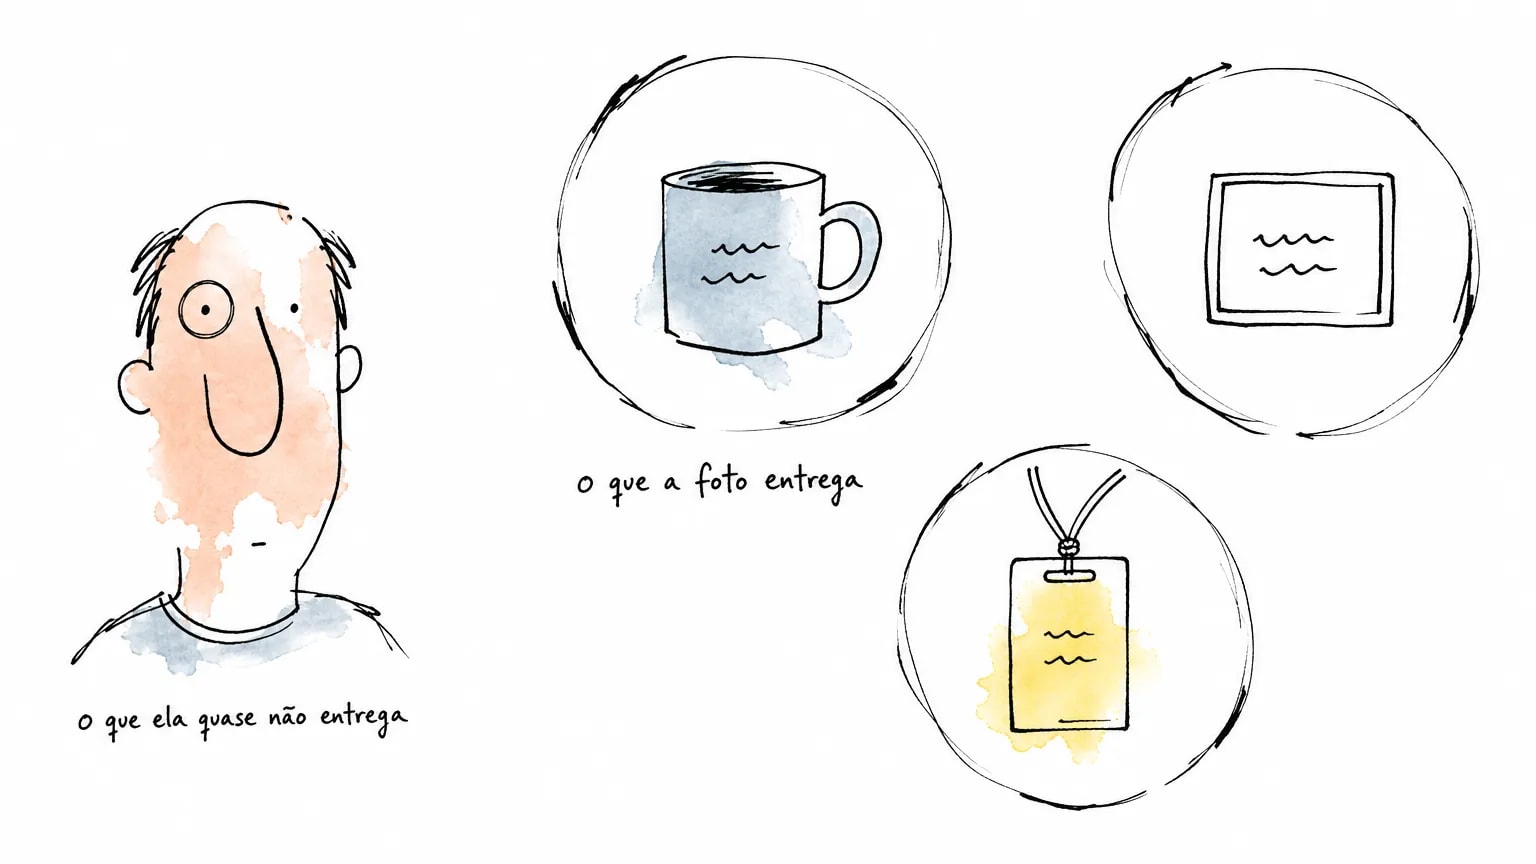
- Texto no seu corpo. Crachá, etiqueta com nome, camiseta escrita, caneca, papel junto ao seu tronco. É a zona mais legível do quadro por geometria pura: está no plano mais próximo da câmera, onde cada centímetro recebe mais pixels. Zoom: o da varredura. Veredicto: tire do quadro antes de fotografar; se já está na foto, recorte. Desfocar texto perto e grande quase nunca fica natural.
- Tela ligada. Monitor atrás de você, notebook à sua frente, celular na mesa. A tela junta texto pequeno com contraste alto, e é o contraste que segura o que a redução de tamanho tende a apagar. Vale como raciocínio, não como medição: a régua desta página mede tamanho, não contraste. Zoom: dobro do zoom da varredura. Veredicto: apagar a tela ou trocar o que está nela custa cinco segundos e resolve por inteiro.
- Vista pela janela. Placa de rua, fachada com nome, número do prédio, letreiro de comércio, morro reconhecível. É a zona que mais surpreende, porque parece longe demais para importar, e a régua da próxima seção mostra que não é. Zoom: dobro do zoom da varredura. Veredicto: gire meio metro. Um passo de lado troca a janela por parede.
- Objeto datável ou único na parede. Diploma com nome e instituição, cartaz de evento com data e cidade, quadro de rotina da família, calendário com marcações. Não entrega endereço: entrega quem você é, onde estudou e em que dia esteve onde. Zoom: o da varredura. Veredicto: tirar da parede é mais barato que recortar, porque esses objetos ficam na altura da cabeça.
- Correspondência e etiqueta. Envelope, caixa de entrega, boleto, comprovante, adesivo de transporte. É a única zona que costuma trazer endereço completo escrito por extenso, com CEP e número. Zoom: dobro do zoom da varredura. Veredicto: fora do quadro, sempre.
- Uniforme, logotipo e etiqueta de empresa. Aqui a decisão se divide: o uniforme costuma ser desejável, porque situa o ofício de quem aparece na foto; o problema é o que está escrito nele, como matrícula, unidade e nome do cliente atendido. Zoom: o da varredura. Veredicto: uniforme sim, texto no uniforme não.
- Terceiros no quadro. Rosto de outra pessoa ao fundo, criança, colega numa reunião atrás de você. Não é problema de privacidade sua, e por isso a correção também é diferente: a decisão passa a ser jurídica, e a última seção trata dela. Zoom: o da varredura. Veredicto: recortar, quase sempre.
- Reflexo em córnea, lente de óculos e superfície brilhante. O susto favorito da internet fecha a lista, e o motivo é medição, não descuido. Zoom: o máximo que o arquivo aguenta, com a regra dos 80 px de íris. Veredicto na maioria absoluta das fotos de perfil: passa. Quando não passa, quem entregou foi a superfície brilhante grande atrás de você, como um quadro com vidro ou a porta espelhada do armário, e não o olho.
Os quatro veredictos possíveis são sempre os mesmos: passa, recorta, desfoca, refaz. Eles custam coisas muito diferentes, e a seção sobre custo mostra quanto cada um cobra antes de você escolher.
A régua: quantos pixels tem cada coisa dentro do seu quadro
A ordem da varredura sai de uma conta, e a conta é simples o bastante para você refazer com a sua própria câmera. As premissas ficam na mesma tela porque é delas que os números saem: foto de 12 MP, ou 4032 x 3024 px; câmera a 1,50 m de você; quadro de 0,60 m de largura no seu plano, que é o enquadramento de cabeça e ombros. As duas últimas vêm do artigo sobre a régua que manda afastar da parede, e o preço dela, para que as contas dos dois textos continuem compatíveis entre si.
Com 4032 px cobrindo 60 cm, sobram 67,2 px por centímetro no seu plano. Qualquer objeto a uma distância D da câmera aparece com 67,2 vezes 1,50 dividido por D pixels por centímetro. É toda a matemática necessária, e ela explica a lista inteira da seção anterior.
| Zona do quadro | Distância até a câmera | Pixels por centímetro | Altura de uma letra de 3 mm (crachá) e de 12 cm (placa de rua) |
|---|---|---|---|
| Seu peito: crachá, caneca, camiseta escrita | 1,50 m | 67,2 | 20 px para a letra de 3 mm |
| Objeto sobre a mesa, um pouco atrás do seu tronco (papel, envelope) | 1,80 m | 56,0 | 17 px para a letra de 3 mm |
| Parede a 0,5 m atrás de você | 2,00 m | 50,4 | 15 px para a letra de 3 mm |
| Parede a 1,5 m atrás de você (a régua deste blog) | 3,00 m | 33,6 | 10 px para a letra de 3 mm; 403 px para a letra de 12 cm |
| Tela de monitor a 2,5 m atrás | 4,00 m | 25,2 | 8 px para a letra de 3 mm; 302 px para a letra de 12 cm |
| Prédio visto pela janela, a 10 m | 11,50 m | 8,8 | 3 px para a letra de 3 mm; 105 px para a letra de 12 cm |
| Placa de rua a 30 m, pela janela | 31,50 m | 3,2 | 1 px para a letra de 3 mm; 38 px para a letra de 12 cm |
Cálculo próprio de 11/08/2026, régua editorial deste blog e não especificação de fabricante. Premissas: foto de 12 MP (4032 px de largura), câmera a 1,50 m e quadro de 0,60 m de largura no seu plano.
Três frases saem dessa tabela e não estão em nenhuma das sete páginas que medi:
- Uma única letra de 3 mm no crachá do seu peito tem 20 px de altura, na mesma foto em que o rosto inteiro refletido na sua córnea tem 7 px: a letra é quase três vezes mais alta que o rosto refletido inteiro.
- Uma placa de rua a 30 metros, vista pela janela, chega a 38 px de altura de letra: quase o dobro da letra do crachá que está a um metro e meio da câmera, e mais de cinco vezes a altura do rosto refletido no seu olho. A coisa mais distante do quadro pode ser a que chega ao arquivo com mais pixels por letra.
- O que entrega você é letra grande longe ou letra pequena perto. O meio do caminho, sem texto nenhum, quase nunca entrega coisa alguma.
Uma advertência precisa viajar junto com esses números: 20 px de altura de letra não é o mesmo que legível. Não existe fonte oficial publicando um limiar de altura de letra em pixels para leitura. A documentação do Tesseract, o mecanismo de reconhecimento de texto aberto mais usado, diz que ele funciona melhor em imagens com pelo menos 300 dpi e remete a um teste de terceiro para o número em pixels. A 300 dpi, uma letra de 3 mm teria cerca de 35 px de altura. Ou seja: os 20 px do crachá ficam na fronteira, abaixo do que a máquina pede com folga e dentro do que um humano ampliando provavelmente lê. Comparar zonas entre si dentro do mesmo quadro é sólido; afirmar que uma delas é legível, no absoluto, não é.
Falta o último trecho do caminho, que é o único que você não controla. Num perfil público testado em 06/08/2026, o arquivo que a web aberta recebe é um quadrado de 200 x 200 px com 6.598 bytes, e a variante de 400 x 400 px pesa 44.812 bytes. A medição saiu do levantamento sobre quanto de foto a web aberta realmente recebe. Do arquivo cheio para esse avatar, tudo divide por cerca de 10: a escala cai de 67,2 para 6,7 px/cm, a letra do crachá vira 2 px, a placa de rua vira 3,8 px e o rosto refletido no seu olho vira meio pixel.
Antes de respirar aliviado, o limite honesto: o avatar é pequeno, mas o arquivo cheio subiu junto. Você não escolhe qual variante a plataforma serve, nem por quanto tempo, nem o que ela vai servir depois da próxima atualização de layout. A régua do avatar calibra o risco de quem vê o seu perfil numa lista; a régua do arquivo cheio é a que vale para quem baixa a imagem.
O reflexo no olho: o que o estudo mediu e o que ele não autoriza a dizer
A crença de que o seu olho guarda uma imagem de quem está na sua frente não é lenda: ela tem um estudo, e o estudo é bom. Rob Jenkins e Christie Kerr publicaram em dezembro de 2013, na PLoS ONE, Identifiable Images of Bystanders Extracted from Corneal Reflections. Eles fotografaram pessoas, recortaram o reflexo na córnea e pediram que observadores pareassem aquele rosto minúsculo com um de dois candidatos.
Os números são os que circulam por aí: observadores não familiarizados com os rostos acertaram 71%, e observadores familiarizados acertaram 84%, com 16 participantes em cada grupo. O detalhe que quase nunca acompanha os números é o desenho da tarefa: era pareamento com duas alternativas, então o acaso sozinho já entrega 50%. Um segundo experimento testou reconhecimento espontâneo, e ali os observadores nomearam rostos que já conheciam. É outra situação, e ela depende de quem olha já conhecer a pessoa refletida.
As condições do experimento são o que muda tudo. A câmera era uma Hasselblad H2D de 39 megapixels, com lente macro de 120 mm, a cerca de 1 metro do rosto, a f/8, ISO 50 e 1/250 s. E, principalmente: dois flashes de estúdio com softbox foram posicionados atrás de anteparos, de cada lado do modelo, com a função declarada de iluminar os figurantes. O laboratório acendeu luz sobre as pessoas refletidas de propósito. Nenhuma foto de perfil sua foi feita assim.
Os pixels fecham o argumento. Os arquivos originais tinham 5.412 x 7.216 px, quase 39 milhões de pixels. A área do rosto do modelo ocupava cerca de 12 milhões deles; a região da íris, cerca de 54.000, menos de 0,5% da área do rosto; e o rosto de um figurante refletido tinha, em média, 322 pixels de área, algo em torno de 0,003% da área do rosto do modelo. Os recortes usados no teste mediam 27 a 36 px de largura por 42 a 56 px de altura, e foram reescalados para 400 px de altura com interpolação bicúbica, com brilho e contraste ajustados automaticamente. Os 71% valem para uma imagem tratada, não para o pixel cru.
Dessas medidas sai a constante que ordena a varredura da primeira seção. Modelando o rosto como uma elipse com altura igual a 1,45 vez a largura, a razão publicada entre íris e rosto dá um diâmetro de íris de cerca de 8,1% da largura do rosto e uma escala linear de 1 para 193 entre o seu rosto e um rosto refletido na sua córnea. A conferência independente é o que dá confiança ao número: o diâmetro corneano horizontal médio, medido em 390 pessoas saudáveis, é de 11,71 mm, com desvio padrão de 0,42 mm, o que sobre uma largura de rosto de cerca de 140 mm dá 8,4%. A régua derivada do estudo e a anatomia publicada batem uma com a outra.
| Onde a foto vive | Largura do seu rosto | Diâmetro da sua íris | Rosto refletido na córnea |
|---|---|---|---|
| O estudo: 39 MP, macro de 120 mm, a 1 m | 3.246 px | 262 px | 17 x 24 px de rosto; os recortes reais, com ombros, tinham 27-36 x 42-56 px |
| Foto de 48 MP, peito para cima | 1.879 px | 152 px | 10 x 14 px |
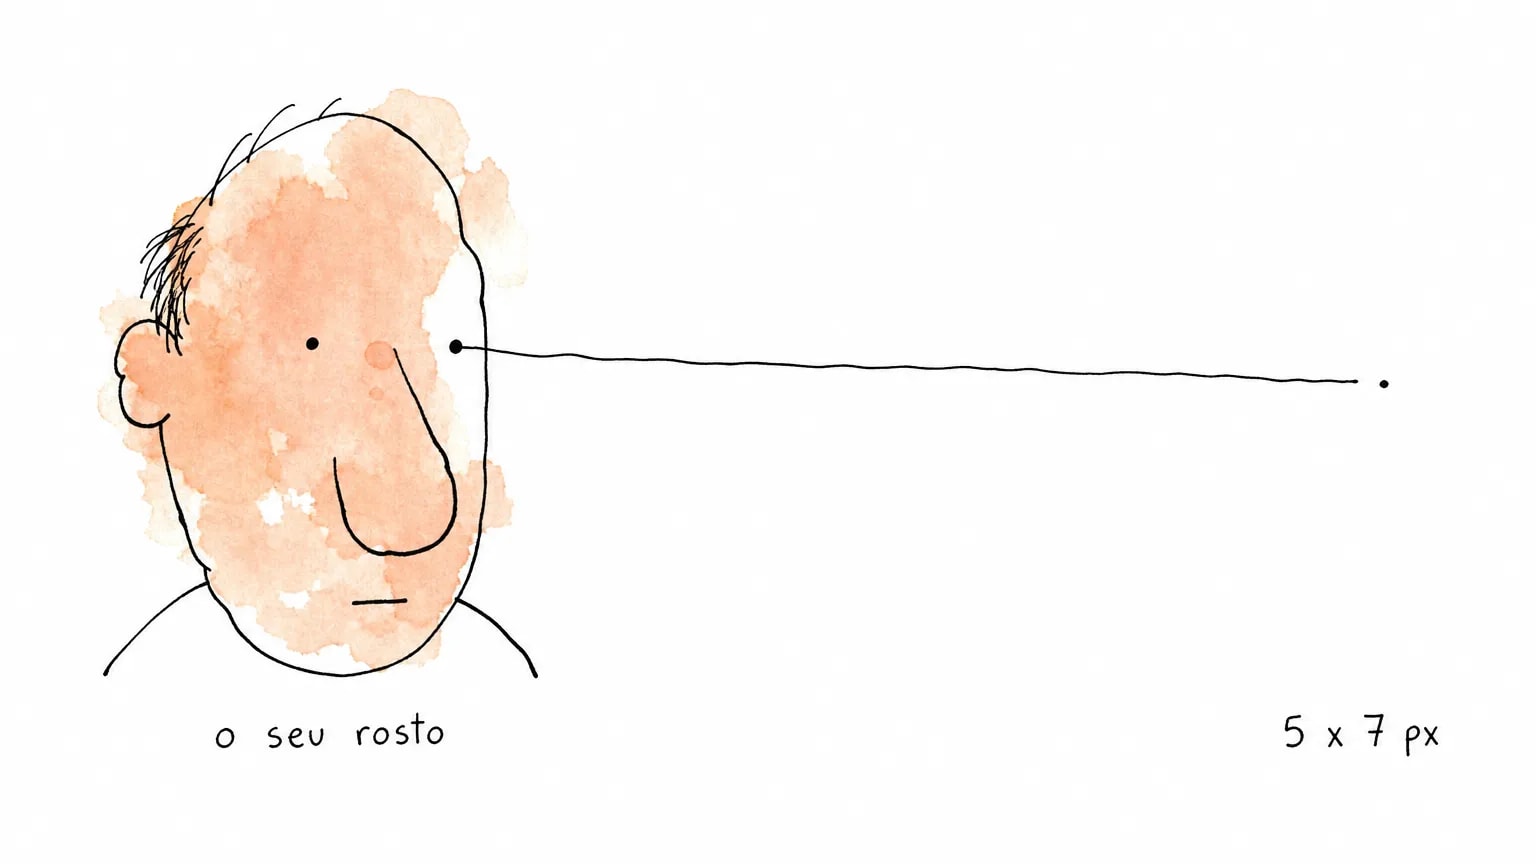
| Foto de 12 MP (4032 x 3024), peito para cima | 939 px | 76 px | 5 x 7 px |
| Foto de 12 MP, recorte fechado só de cabeça e queixo | 2.419 px | 195 px | 13 x 18 px |
| Saída 1:1 do fotoslinkedin (1024 x 1024) | 512 px | 41 px | 3 x 4 px |
| Avatar de 400 x 400 servido pela plataforma | 200 px | 16 px | 1 x 1,5 px |
| Avatar de 200 x 200 servido pela plataforma | 100 px | 8 px | 0,5 x 0,8 px |
Cálculo próprio de 11/08/2026, derivado das medidas publicadas por Jenkins e Kerr (2013) e das premissas de enquadramento declaradas no texto. Régua editorial deste blog, não especificação de fabricante.
O próprio artigo lembra que rosto familiar sobrevive a resoluções absurdamente baixas: os autores citam medições em que observadores identificaram rostos conhecidos com resolução equivalente a 7 x 10 px, e a Figura 1 do trabalho mostra um rosto famoso reconhecível a 16 x 20 px. Esse é o argumento mais forte a favor do reflexo, e ainda assim ele não alcança a sua foto de perfil: 5 x 7 px numa foto de 12 MP fica abaixo de 7 x 10, antes de qualquer compressão, sem os dois flashes do estúdio e sem alguém que já conheça a pessoa refletida.
Uma nota de fronteira, porque este blog já trata o mesmo objeto pelo outro lado. Quando o assunto é qualidade de imagem, o reflexo na lente é defeito, e o blog já tratou o mesmo retângulo na lente, visto como defeito de imagem. Lá o objetivo é apagá-lo; aqui é lê-lo. As duas leituras convergem numa recomendação só: se existe um retângulo claro na sua lente, ele é uma tela ou uma janela, e tirar isso do caminho resolve o defeito e a informação na mesma tacada.
O que a máquina deduz do fundo hoje, e por que é o texto que entrega
Trocando o susto por uma pergunta respondível: um modelo de visão consegue dizer onde a sua foto foi tirada? Consegue, e o desenho da medição importa mais que o número que sai dela.
O trabalho de referência é Granular Privacy Control for Geolocation with Vision Language Models, de Mendes, Chen, Hays, Das, Xu e Ritter, apresentado no EMNLP 2024. Os autores montaram um conjunto chamado GPTGeoChat com 1.000 imagens e 1.000 diálogos, 4.072 turnos anotados em cinco granularidades: país, cidade, bairro, nome exato do local e coordenada de GPS. As imagens foram compradas num banco de imagens, e os anotadores receberam duas instruções que importam para ler o resto: priorizar cenas cotidianas parecidas com foto pessoal de rede social, e priorizar imagens que trazem texto em placa ou cartaz.
O número que muda o comportamento de quem lê está na descrição do conjunto: 85% das imagens contêm algum texto, contra 19% no conjunto de teste IM2GPS e 25% no IM2GPS3K. Esse número é consequência declarada da instrução acima, e não um retrato de quantas fotos do mundo têm letra: os autores queriam um conjunto que exigisse raciocínio em vez de reconhecimento de monumento. O que ele mostra é o que passa a ser possível quando existe texto no quadro, e é por isso que o texto abre a varredura em vez de fechá-la.
Sobre o desempenho bruto, o mesmo trabalho registra que o GPT-4v supera sistemas especializados no conjunto de teste IM2GPS: prevê a localização com precisão de rua, abaixo de 1 km, em 24% dos casos, e tem o menor erro mediano de distância, 13 km. O limite obrigatório: o IM2GPS é feito de fotos escolhidas por terem pista geográfica. Não é a sua foto de perfil contra uma parede lisa.
E onde a máquina ainda falha é justamente a granularidade que assusta. Os autores escrevem que modelos ajustados empatam com modelos de API acionados por prompt ao identificar vazamento de local em nível de país ou cidade, mas que identificar granularidades finas, como o nome de um restaurante ou de um prédio, parece exigir ajuste com dado supervisionado. País e cidade são a parte fácil; o endereço continua sendo a parte difícil, e o que encurta essa distância é texto no quadro.
Existe um segundo ângulo, vindo da documentação de quem vende reconhecimento. A página de imagens suportadas da Vision API do Google recomenda 1600 x 1200 px para detecção de rosto e 1024 x 768 px para detecção de texto, sobre um mínimo geral de 640 x 480 px. São as duas únicas linhas da tabela que sobem acima desse mínimo, e a página explica cada uma: para rosto, porque a distância entre os olhos é o que mais importa; para texto, nas palavras dela, porque o reconhecimento de caracteres exige mais resolução para detectar caracteres. Vale ler a tabela sem torcer: o número maior é o do rosto, e a doc não afirma que letra custa mais que rosto. O que os dois casos têm em comum é o que interessa aqui: o que decide não é o tamanho do arquivo, é quantos pixels sobram em cima de um detalhe pequeno dentro do quadro. E é recomendação de tamanho de imagem inteira, nunca de altura de letra.
| Granularidade | O que a evidência mostra | O limite declarado | O que fazer no seu quadro |
|---|---|---|---|
| País e cidade | Modelos ajustados empatam com modelos de API acionados por prompt ao identificar vazamento de local nesse nível | É o nível mais fácil e não depende de detalhe fino da imagem | Quase qualquer foto externa entrega isso. Não é aqui que vale gastar esforço |
| Rua, abaixo de 1 km | No conjunto IM2GPS, o GPT-4v acerta abaixo de 1 km em 24% dos casos, com erro mediano de 13 km | O IM2GPS é feito de fotos escolhidas por terem pista geográfica | O que aproxima a sua foto desse conjunto é ter pista: letreiro, fachada, monumento |
| Nome exato do local | Identificar nome de restaurante ou de prédio parece exigir ajuste com dado supervisionado, segundo os autores | Não é capacidade disponível por prompt num modelo genérico | É o nível que assusta e o menos maduro. Quem encurta essa distância é texto |
| Texto dentro da imagem | 85% das imagens do GPTGeoChat têm texto, contra 19% no IM2GPS e 25% no IM2GPS3K | É escolha de projeto do conjunto, para exigir raciocínio | Tirar letra do quadro é a correção com maior retorno por pixel gasto |
| Custo de resolução | A Vision API recomenda 1600 x 1200 px para rosto e 1024 x 768 px para texto, sobre um mínimo geral de 640 x 480 px | Recomendação de tamanho de imagem inteira, não de altura de letra; o número maior é o do rosto, e a doc não compara os dois casos entre si | Pela régua desta página, no avatar de 200 px a letra do crachá cai para 2 px e o seu rosto ainda tem 100 px de largura: quem morre primeiro é o texto |
Mendes, Chen, Hays, Das, Xu e Ritter (2024), GPTGeoChat, EMNLP; documentação da Vision API do Google. Conferidas em 11/08/2026.
O que aparece, o que entrega e quanto custa corrigir
Varredura feita, resta escolher a correção. A escolha é econômica, não moral: cada veredicto cobra um preço diferente, e o erro mais comum é pagar caro por uma zona que não pedia nada.
| O que aparece no quadro | O que ele entrega | Correção proporcional | Quando isso não importa |
|---|---|---|---|
| Crachá, etiqueta com nome, camiseta escrita | Nome completo, empresa, matrícula, às vezes unidade e andar | Tirar antes de fotografar. Já publicada, recortar | Camiseta lisa, caneca sem escrita, crachá virado para dentro |
| Tela ligada, atrás ou à frente | Nome de cliente, sistema interno, planilha, conversa aberta | Apagar a tela e refazer. Desfocar tela é o borrão mais visível de todos | Tela desligada, tela mostrando só papel de parede |
| Janela com placa, fachada ou número de prédio | Cidade, bairro e, com letreiro legível, a rua | Girar meio metro e refazer. Desfocar resolve, mas só a janela | Vista de céu, de copa de árvore ou de prédio sem identificação |
| Diploma, cartaz de evento, calendário, quadro de rotina | Formação, instituição, data e cidade de um evento, rotina da casa | Tirar da parede. Recortar costuma cortar a sua cabeça junto | Parede lisa, quadro abstrato, estante sem etiqueta |
| Envelope, caixa de entrega, comprovante | Endereço completo com número e CEP | Fora do quadro. É a única zona sem meio-termo | Nunca deixa de importar enquanto o endereço estiver escrito |
| Uniforme com texto bordado | Empregador, unidade, número de registro profissional | Trocar a peça ou recortar acima do bordado | Uniforme liso, jaleco sem nome, camisa social |
| Rosto de outra pessoa ao fundo | A imagem de alguém que não escolheu aparecer | Recortar. Pedir autorização é correto e mais caro | Pessoa de costas, silhueta irreconhecível, multidão distante |
| Reflexo na córnea, na lente ou em superfície brilhante | Formas grandes e claras diante de você, raramente um rosto identificável | Passa, na maioria das fotos. Se a superfície brilhante for grande, mude o ângulo | Íris com menos de 80 px no zoom da varredura, ou avatar pequeno |
Ordenação por legibilidade medida, conforme a régua em pixels por centímetro publicada nesta página. Cálculo próprio de 11/08/2026.
Os quatro custos, em ordem crescente de dor:
- Trocar o destino custa zero. Nem toda foto precisa ser derrubada: às vezes ela só está no lugar errado. A mesma imagem que não serve para um perfil público aberto pode servir para um cadastro interno, onde o público é conhecido.
- Refazer custa tempo, e devolve mais do que tira. É a única correção que também melhora luz, pose e enquadramento, porque você reencena a cena inteira. Quando o problema é uma coisa que se desliga ou se tira da parede, refazer é quase sempre mais barato que editar.
- Recortar custa pixels do rosto. Um recorte de 20% na largura e na altura descarta cerca de 36% da área da imagem, e o que sobra ainda precisa preencher o quadrado que a plataforma pede. Se a foto já saiu em 1024 x 1024 px, esse recorte deixa 819 px de lado antes de qualquer reamostragem.
- Desfocar custa credibilidade. Borrão local num retrato tende a ser lido como retoque, e retoque é a primeira coisa que levanta suspeita de imagem editada. Desfoque só funciona bem numa zona pontual e distante, como uma placa na janela; em texto perto e grande, ele grita.
O desempate: afastar da parede aumenta o fundo visível
Duas recomendações deste blog brigam entre si, e é mais honesto escrever o desempate do que fingir que elas convivem. A régua de distância ao fundo manda você ficar a 1,5 m da parede, e ela está certa: é o que joga a sombra da sua cabeça para fora do quadro, derruba a luz que chega na parede em 2,64 stops e dá ao modo Retrato uma diferença de profundidade para recortar. Só que a mesma manobra aumenta a área de ambiente que entra na foto.
A régua em pixels por centímetro mostra o preço com número. No seu plano, a escala é de 67,2 px/cm. Com a parede a 1,5 m atrás de você, a distância dela até a câmera passa de 1,50 m para 3,00 m e a escala cai para 33,6 px/cm: metade da resolução por centímetro. Ao mesmo tempo, o campo de visão cobre o dobro da largura naquele plano. Menos detalhe por centímetro, mais centímetros dentro da foto. As duas coisas acontecem juntas, e nenhuma anula a outra.
A regra de decisão que este blog propõe, declarada como raciocínio editorial e não como recomendação de fabricante: quanto mais fundo visível, menos identificável ele precisa ser. O teste que torna a regra operável cabe numa pergunta: isso que está atrás de mim existiria igual em mil casas? Parede lisa passa. Estante genérica passa. Diploma com o seu nome, cartaz com data e cidade, janela com vista reconhecível não passam, e o afastamento só piora o caso deles.
Mantida a distância que a sombra pede, o que resta escolher é o que ocupa o fundo: parede lisa, uma superfície neutra no lugar da janela, ou o mesmo cenário de trabalho com os objetos escritos trocados por objetos sem texto, como livro com a lombada para dentro, planta ou caixa sem etiqueta.
Escolher tom, textura e contraste do que fica atrás é outra decisão, com critério visual próprio, e ela tem página dedicada: o fundo escolhido por critério visual, e não por privacidade. Aqui a pergunta é só uma: quanto daquele fundo é identificável.
Já publicou: recortar, desfocar, refazer ou trocar o destino
A varredura vale mais antes, e quase todo mundo chega aqui depois. Com a foto no ar, sobram as mesmas quatro saídas, agora vistas pelo outro lado: não o que cada uma cobra, que está na seção anterior, mas o que cada uma resolve e o que ela deixa de pé. O erro é escolher pela pressa, e não pela zona.
- Recortar. Resolve tudo que está na borda do quadro: janela na lateral, envelope no canto da mesa, colega ao fundo fora do eixo. Não resolve o que está entre você e a câmera, nem o que está exatamente atrás da sua cabeça.
- Desfocar ou cobrir. Resolve uma zona pontual e distante, como uma placa vista pela janela ou um nome numa lombada. Não resolve texto perto e grande, porque o borrão fica do tamanho do objeto e vira a coisa mais visível da imagem.
- Refazer. Resolve tudo, porque o problema deixa de existir na captura em vez de ser escondido depois. Não resolve nada do que já circulou.
- Trocar o destino. Resolve o descompasso entre a imagem e o público dela: a mesma foto pode continuar num cadastro fechado e sair do perfil público. Não resolve nada dentro da imagem.
Existe uma quinta coisa que costuma ser confundida com essas quatro. O metadado da foto, com data, modelo de câmera e a coordenada de GPS que o celular grava, é outra camada: ela vive dentro do arquivo, não dentro da imagem, e sai com um comando. Esse assunto tem página própria: a camada que vive dentro do arquivo, e não dentro da imagem. A frase que separa as duas coisas sem ambiguidade: o metadado você apaga com um comando; o que está no quadro só sai recortando, desfocando ou refazendo.
E o limite duro desta seção, que nenhuma das quatro saídas alcança: trocar a foto do perfil não recolhe cópia que já circulou. Uma imagem publicada pode ter sido salva, indexada ou reaproveitada por terceiros, e isso deixa de ser um problema de enquadramento. Quando vira uso indevido por outra pessoa, o roteiro é outro: o que fazer quando a sua foto já apareceu num perfil que não é seu.
O que é seu e o que é de terceiro dentro do quadro
Sete das oito zonas tratam de informação sua, e você decide sozinho o que fazer com elas. Uma não: a sétima da lista, terceiros no quadro. A diferença ali é de natureza, não de grau.
Rosto de outra pessoa no seu fundo não é um problema de privacidade sua: é a imagem de alguém que não escolheu estar ali. A decisão deixa de ser estética e passa a ser jurídica. O uso da imagem de uma pessoa é tratado no art. 20 do Código Civil, e este blog não reescreve a regra dentro de um guia de fotografia: quem trata dela com a lei na mão é o artigo sobre o direito de imagem de quem aparece sem ter escolhido.
Os casos que mais aparecem numa foto de perfil, e o que cada um pede:
- Colega ao fundo, de frente e reconhecível. Recorte. É a correção mais barata e não custa quase nada ao retrato, porque a pessoa está sempre fora do eixo central.
- Criança no quadro. Fora, sem discussão. Numa foto de perfil profissional a criança não acrescenta nada à mensagem, e a decisão nem sequer é sua sozinha.
- Tela com nome de cliente, número de processo ou dado de paciente. Aqui não é só imagem de terceiro: é informação de terceiro sob a sua guarda. A tela sai do quadro, e essa é a única correção aceitável.
- Foto de grupo pendurada na parede. Depende do tamanho no quadro. Pela régua, um rosto de 3 cm dentro de um porta-retrato pendurado a 1,5 m atrás de você fica com cerca de 100 px de largura, muito acima dos 7 x 10 px que o estudo do reflexo cita como piso para reconhecer um rosto já familiar. Se estiver reconhecível no zoom da varredura, sai.
Quando pedir e quando recortar? Pedir autorização é correto e caro: depende de outra pessoa, de tempo e de um registro para guardar. Recortar custa pixels e cinco segundos. Numa foto de perfil, que é um retrato de você, o terceiro ao fundo não acrescenta nada ao que a imagem precisa comunicar.
O fundo que entra na foto sai do estilo, não do seu quarto
A geração parte de 1 a 5 fotos suas. Luz, fundo e enquadramento vêm das fotos de referência do estilo; corte, expressão e roupa vêm de você. Saída de 1024 x 1024 px, teste de 1 imagem.
Perguntas frequentes
Dá para descobrir onde a minha foto foi tirada só olhando a imagem?
Um reflexo no meu olho mostra mesmo quem está na minha frente?
Preciso apagar o metadado antes de publicar a foto de perfil?
Desfocar o fundo resolve, ou é melhor refazer?
Apareceu outra pessoa no fundo. Preciso de autorização?
Resumo e próximos passos
O que a sua foto entrega além do rosto é, quase sempre, texto e vista. A córnea é a zona menos legível do quadro, e isso não é opinião: numa foto de 12 MP de peito para cima o rosto refletido no seu olho tem 5 x 7 px, enquanto a letra de 3 mm de um crachá no seu peito tem 20 px e a letra de 12 cm de uma placa de rua a 30 metros, vista pela janela, tem 38 px.
A rotina que sobra depois de fechar esta página cabe em três gestos: abrir o arquivo no tamanho original e ampliar até o rosto ocupar a tela; varrer texto e vista antes de olhar o olho; e escolher a correção mais barata que resolve a zona, entre passar, recortar, desfocar e refazer. O resto é o de sempre, e vale mais que qualquer edição: a cena se resolve na captura, e é disso que trata o guia que decide o que entra no quadro antes do clique.
Se a sua próxima foto vai ser feita em casa, com a parede a 1,5 m, vale ler junto por que essa distância também muda a sombra e o desfoque, porque as duas decisões acontecem no mesmo passo para trás.
Pedro Mota
Fundador, fotoslinkedin.com.br
Pedro Mota é fundador da fotoslinkedin.com.br, ferramenta de IA que transforma uma selfie em foto profissional pronta pro Linkedin em 60 segundos. Antes, atuou com design e produto digital. Hoje vê centenas de fotos por semana e escreve sobre o que funciona pra carreira no Brasil em 2026.