O nome certo de cada coisa, e o model ID que não existe
O lançamento de 8 de setembro de 2026 colocou três nomes em circulação no mesmo dia, e é aí que quase tudo que já foi escrito escorrega. ChatGPT Images 2.5 é o produto dentro do ChatGPT: é o que responde quando você pede uma imagem no aplicativo. GPT Image 2.5 é a família na API. E na API não existe um modelo chamado GPT Image 2.5: existem dois, cada um com nome próprio, mais dois snapshots datados.
gpt-image-2.5-flare: o modelo pequeno. O model card do Flare o descreve como "our fastest model for high-quality, everyday image generation", ou seja, o mais rápido para geração de imagem do dia a dia.gpt-image-2.5-sunburst: o modelo base. O model card do Sunburst diz "use it for workflows where editing precision matters most", isto é, para fluxos em que a precisão da edição é o que mais importa.gpt-image-2.5-flare-2026-09-08egpt-image-2.5-sunburst-2026-09-08: os snapshots datados. Os dois estão declarados como snapshot padrão do respectivo apelido, o que significa que hoje chamar o apelido é chamar essa versão.
A ausência do identificador genérico não é leitura de documentação, é medição nossa de 09/09/2026. Consultamos GET /v1/models/{id} um ID por vez, com a chave de produção do fotoslinkedin. Esse endpoint de metadados não cobra nada. O pedido por gpt-image-2.5 devolveu 404 com a mensagem literal "The model 'gpt-image-2.5' does not exist"; os dois apelidos, os dois snapshots e o gpt-image-2 devolveram 200. Se você copiou o ID genérico de algum tutorial desta semana, ele não roda.
O mesmo endpoint devolve o campo created: nesta conta os dois apelidos foram criados em 04/09/2026, quatro dias antes do anúncio, e os snapshots em 08/09/2026. São dez modelos de imagem visíveis, quatro deles da família 2.5. É a lista desta conta, não um catálogo universal.
A distinção entre produto e API tem consequência prática: quase tudo que o anúncio oficial de 8 de setembro celebra é do aplicativo, não da API. Sketch (acionado digitando @Sketch), os templates prontos como "Poster" e "Merch", comentar sobre a imagem e compartilhar o prompt junto com ela são recursos de interface. Se o seu caminho é a interface, o método em pt-BR está em o passo a passo dentro da interface do ChatGPT. Se ainda está decidindo entre prompt manual, aplicativo e fotógrafo, o mapa completo é o guia técnico de foto profissional com IA.
| A sua situação | Comece por | Por que esse | O que conferir antes de fechar |
|---|---|---|---|
| Primeira geração, você ainda está descobrindo o prompt | Flare | Cada tentativa volta mais rápido, e nesta fase o número de tentativas é o que decide | Se o rosto e a luz já servem, não troque de modelo: mexa no que você escreveu |
| Lote de conteúdo, muitas imagens por dia | Flare | Model card: geração de alta qualidade para o dia a dia. Medimos 21,2% a 30,0% menos tempo que o gpt-image-2 | Custo por imagem aceita, não por chamada concluída. Chamada que volta e você descarta custou igual |
| Edição do rosto: trocar roupa ou fundo sem perder a semelhança | Sunburst | Model card: use para fluxos em que a precisão da edição é o que mais importa | Três execuções do mesmo pedido. Olhe o rosto primeiro, a luz depois, o fundo por último |
| Campanha com várias revisões em cima da mesma imagem | Sunburst | O desvio de identidade se acumula turno a turno, e o modelo base é o que a doc aponta quando a precisão da edição pesa | Teste a sequência inteira de edições, não só o primeiro passo. O desvio aparece na terceira |
| Você já tem um fluxo no gpt-image-2 que atende | Flare | É a recomendação da tabela oficial de migração para esse caso | Mantenha prompt, referências, tamanho e formato idênticos na primeira comparação |
| O gpt-image-2 não dá conta de um caso complexo seu | Sunburst | Também é a recomendação da tabela oficial de migração, invertida | Primeiro prove a qualidade. Só depois teste se o Flare alcança o mesmo resultado |
Coluna 'por que esse': guia oficial de image prompting e model cards da OpenAI, consultados em 09/09/2026. As porcentagens de tempo são medição nossa do mesmo dia, em 1024x1024 e quality low.
Flare ou Sunburst: a escolha é por tarefa, não por preço
Nenhuma linha da tabela acima diz que um modelo é melhor. O que muda é o que você está fazendo. Quando o gargalo é quantas tentativas você faz numa tarde, o Flare ganha. Quando o gargalo é o quanto a imagem 1 sobrevive à edição, o Sunburst ganha.
A formulação oficial mais precisa está no guia de image prompting da OpenAI: "GPT Image 2.5 Flare is the small model, optimized for speed, with image quality comparable to GPT Image 2. GPT Image 2.5 Sunburst is the base model, optimized for quality, with higher image quality than GPT Image 2. Both models offer improvements in precise editing and subject preservation." Em pt-BR: o Flare é o pequeno, otimizado para velocidade, com qualidade comparável à do GPT Image 2; o Sunburst é o base, otimizado para qualidade, com qualidade superior à do GPT Image 2; e os dois melhoraram em edição precisa e preservação do sujeito.
Vale registrar uma diferença entre duas páginas oficiais publicadas no mesmo dia. O anúncio de produto escreve que o Flare entrega "higher-quality images than GPT-Image-2 at 50% lower latency". O guia de image prompting escreve "comparable" para o Flare e reserva "higher image quality" para o Sunburst. Adotamos a formulação do guia, que é a mais conservadora, e registramos a do anúncio com o nome da página: quem lê precisa saber qual das duas está sendo citada.
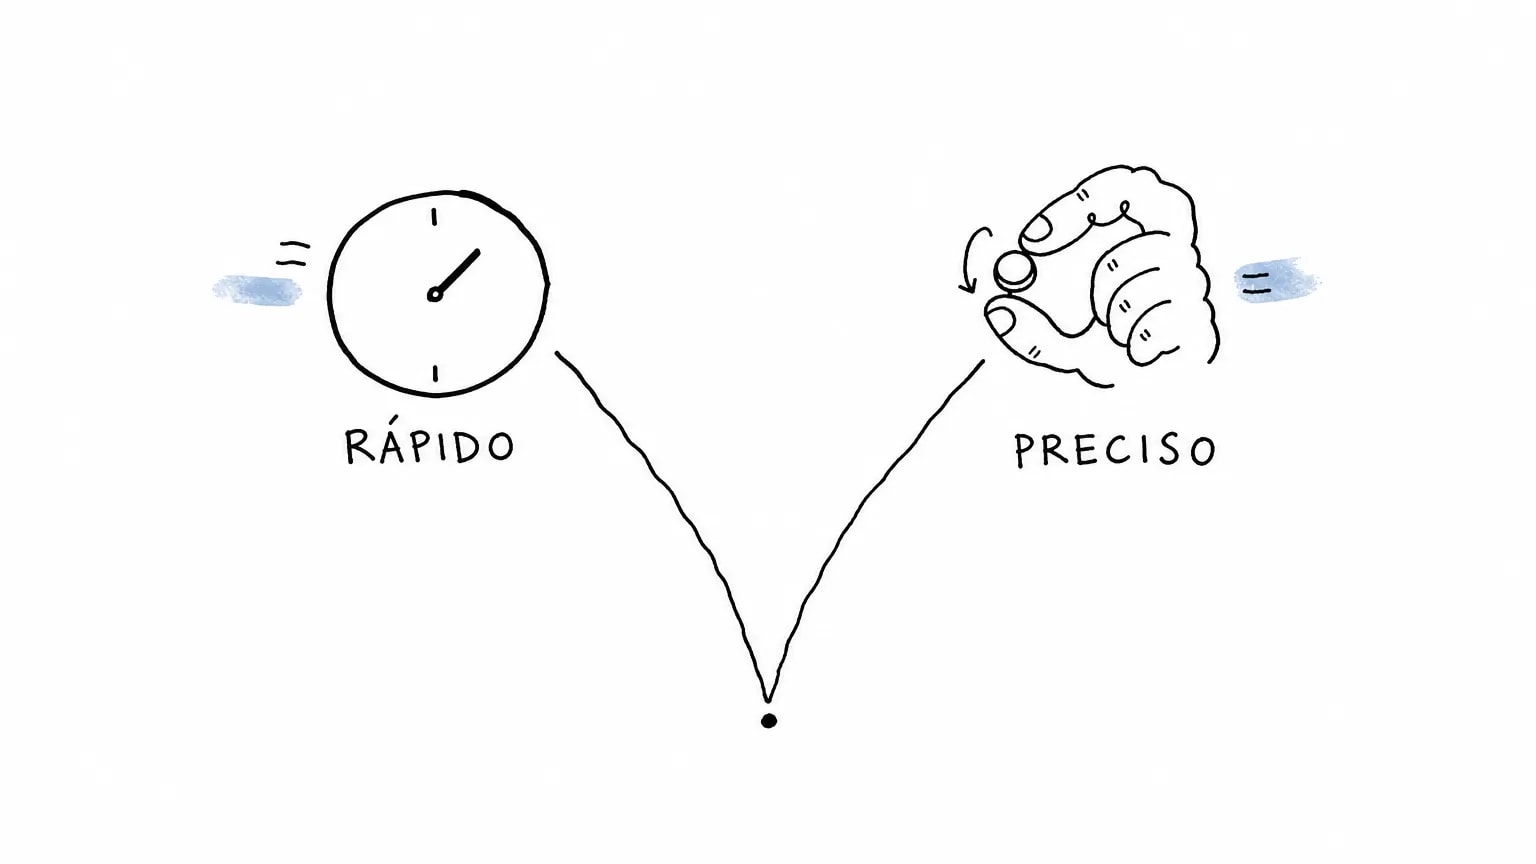
A tabela oficial de migração é mais curta que a nossa e diz o mesmo: fluxo em gpt-image-2 que já atende, comece pelo Flare; caso complexo em que o gpt-image-2 não atende, comece pelo Sunburst. Note o verbo: comece. É o ponto de partida do seu teste, não uma atribuição definitiva. E o teste é seu porque o guia avisa, com estas palavras, que "a speed improvement on one workload doesn't establish a fixed improvement on another". O que não entra na decisão é preço: os dois estão na mesma linha da tabela de custo, e é disso que trata a próxima seção.
O que a OpenAI publica igual nos dois (e o que ela não publica)
Fizemos o diff das páginas oficiais linha por linha em 09/09/2026, e a lista de diferenças é quase vazia.
- Preço: idêntico. Nos dois model cards e na página de preços da API, Flare e Sunburst custam US$ 5,00 por milhão de tokens de texto de entrada (US$ 1,25 em cache), US$ 8,00 por milhão de imagem de entrada (US$ 2,00 em cache) e US$ 30,00 por milhão de imagem de saída. Em dólar, consultado em 09/09/2026.
- Preço contra o modelo anterior: idêntico também. A doc escreve "Token rates match GPT Image 2", e o snapshot da página de preços de 07/09/2026, a véspera, mostra a coluna Standard do
gpt-image-2já em US$ 5,00 / US$ 8,00 / US$ 30,00. Nada subiu, nada caiu. - Endpoints: os mesmos dois.
v1/images/generationsev1/images/edits. A única diferença entre as gerações é que ogpt-image-2suportav1/batche nenhum dos 2.5 suporta. - Limites de taxa: os mesmos cinco degraus. 100.000, 250.000, 800.000, 3.000.000 e 8.000.000 de tokens por minuto, e 5, 20, 50, 150 e 250 imagens por minuto, conforme o tier. São os limites padrão.
- Escada de qualidade: a mesma, e ela cresceu. Os dois aceitam
auto(padrão),low,medium,high,xhighemax. Os dois últimos são novidade real do 2.5. - Funcionalidades listadas: uma só, e é a mesma. Em "Supported features" os dois model cards trazem apenas
inpainting, exatamente como o dogpt-image-2. Nenhuma menção a "identidade", "fidelidade" ou "estilo" como recurso próprio: essa ausência foi conferida, não presumida.
A leitura é nossa e é esta: nas páginas públicas da OpenAI, preço, endpoints, limites de taxa, escada de qualidade e lista de funcionalidades não separam Flare de Sunburst. O que separa é uma frase de posicionamento e o comportamento que você mede. Efeito colateral prático: qualquer texto que diga "o Sunburst é o caro" está errado hoje, e você confere em dois cliques. O guia antecipa o erro contrário também, com "Confirm current pricing rather than assuming the faster model costs less". Aqui o mais rápido não custa menos: custa igual.
Os oito fundamentos de prompt do GPT Image 2.5, traduzidos para foto profissional
Junto com os modelos, a OpenAI publicou um guia de prompting numerado em oito fundamentos. Não são específicos de retrato, mas encaixam. Traduzidos para foto de perfil:
- Defina o resultado. Para que serve a imagem e como ela vai ser cortada. "Foto de perfil, do peito para cima, 1:1" resolve mais que qualquer adjetivo.
- Escolha um formato mantenível. Prosa, lista, bloco rotulado, estrutura tipo JSON: tanto faz. Escolha o que você consegue reler e editar em duas semanas.
- Descreva detalhes visíveis. Superfícies, não conceitos: poros, fios soltos, trama do tecido, textura da íris. E peça "photorealistic" com essa palavra, se é isso que você quer.
- Especifique pessoa e ação. Quem é, para onde olha, o que faz com ombros e mãos. Retrato quebra mais por pose e mãos do que por luz.
- Especifique o texto exato. Em retrato, o texto exato quase sempre é nenhum. "Sem texto, sem crachá, sem logotipo, sem marca d'água" é usar o fundamento a seu favor.
- Separe o que muda do que fica. Literal do guia: "say 'change only X' and list the details to preserve, such as identity, geometry, layout, lighting, or labels". É o núcleo de toda edição de retrato.
- Atribua papel a cada referência. "Identify each input by number and purpose: subject, style, clothing, or background." Imagem 1 é você, imagem 2 é a roupa, imagem 3 é o fundo.
- Itere deliberadamente. Passe a saída anterior como entrada da próxima edição, peça uma mudança e repita a lista do que precisa ficar igual.
Guarde o fundamento 2, porque ele derruba metade do que se vende como técnica de prompt: "Short prompts, descriptive paragraphs, JSON-like structures, instructions, and tags can all express the same intent. Choose the format that makes the requirements easiest to read and update rather than relying on special syntax." Em pt-BR: prompt curto, parágrafo, estrutura tipo JSON e tags expressam a mesma intenção; escolha o formato mais fácil de ler e atualizar, em vez de contar com sintaxe especial. Vale inclusive para a anatomia de seis componentes que a nossa própria biblioteca de prompts usa: é uma escolha de legibilidade, não um mecanismo. O que decide o resultado é a cobertura, não o molde.
Abaixo os oito fundamentos viraram um bloco preenchível, já na linguagem de retrato. Copie, troque o que está entre sinais de menor e maior, e apague os campos 6 e 7 quando estiver gerando do zero em vez de editando.
1. RESULTADO       Foto profissional de perfil, uso: Linkedin e currículo.
                   Enquadramento do peito para cima. Proporção 1:1.
2. FORMATO         Este bloco de 8 campos, texto simples, um campo por linha.
3. DETALHES        Luz de janela vindo da esquerda da câmera, preenchimento suave,
   VISÍVEIS        sombras reais. Perspectiva de retrato 85 mm, profundidade rasa.
                   Fotografia corporativa editorial real: poros visíveis, fios
                   soltos, trama do tecido no colarinho, íris com textura.
                   Sem retoque de beleza.
4. PESSOA          A imagem 1 é a única referência de identidade. Preserve formato
   E AÇÃO          do rosto, tom de pele, idade, cabelo e assimetrias naturais.
                   Olhar na câmera, ombros levemente de lado, sorriso contido de
                   boca fechada, mãos fora do quadro.
5. TEXTO EXATO     Nenhum texto na imagem. Sem crachá, sem logotipo, sem marca
                   d'água.
6. O QUE MUDA      [só em edição] Mude apenas: <a roupa | o fundo | a luz>.
7. O QUE FICA      [só em edição] Preserve: rosto, traços, tom de pele, cabelo,
                   proporções, pose, enquadramento, ângulo da câmera, expressão,
                   temperatura de cor e nitidez.
8. REFERÊNCIAS     Imagem 1 = eu (identidade). Imagem 2 = peça de roupa.
                   Imagem 3 = fundo. Mantenha a pessoa da imagem 1 e use as
                   imagens 2 e 3 apenas como material.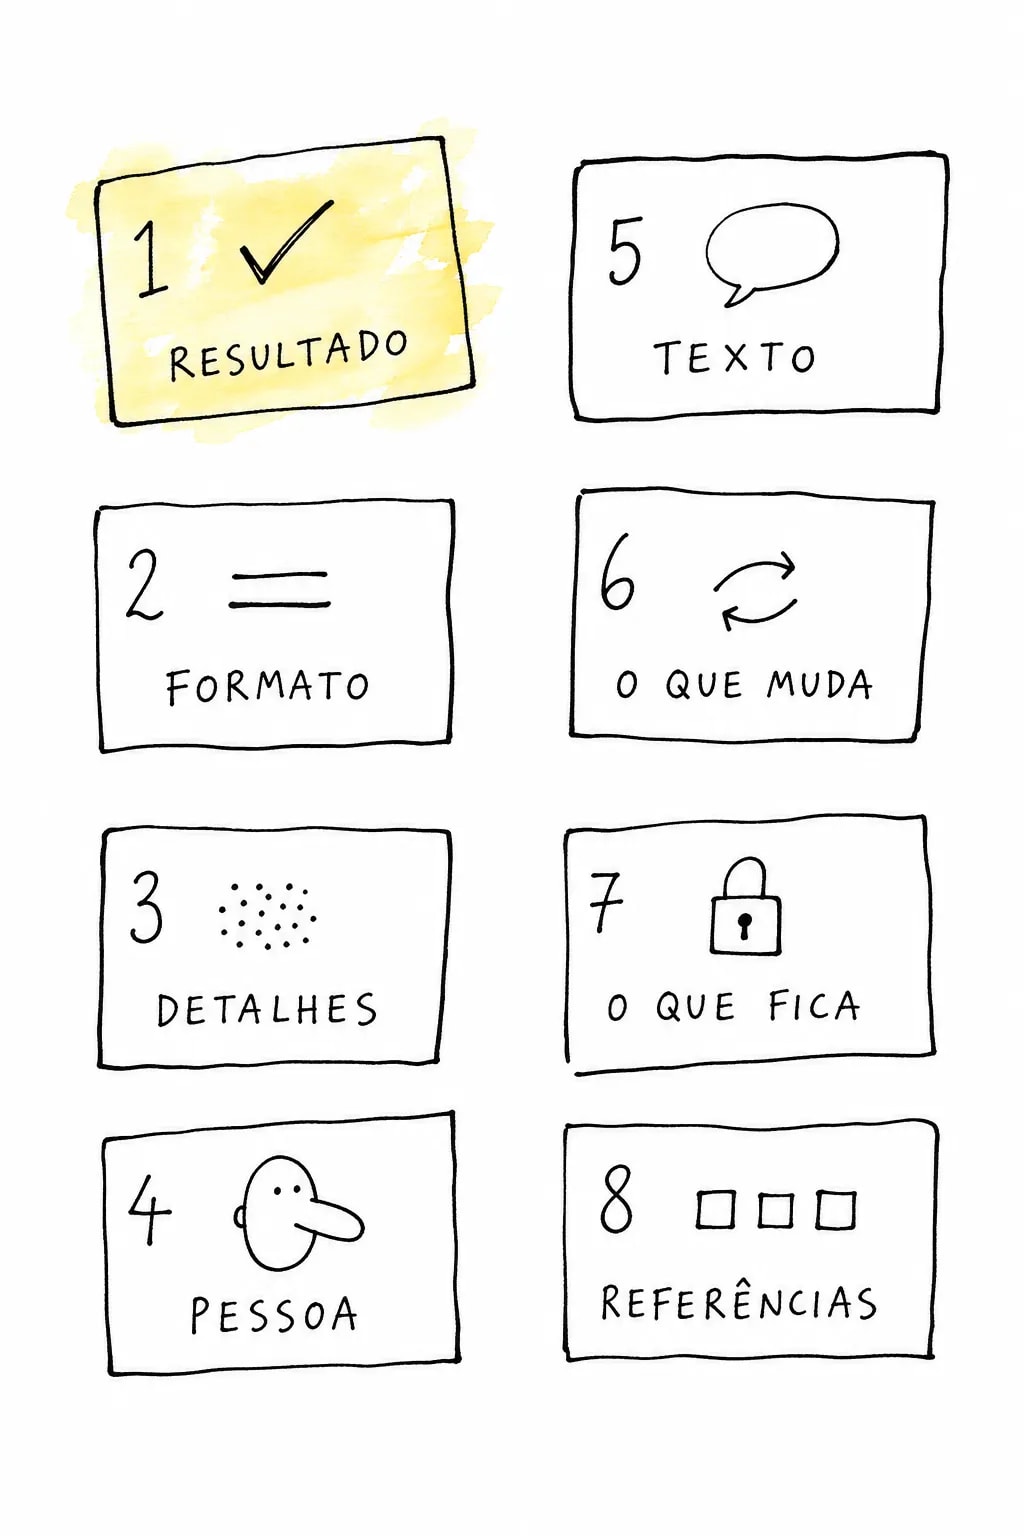
Por que cada campo está aí, que é a parte que ninguém escreve:
- O campo 2 existe para você não procurar sintaxe secreta. É o fundamento 2 virado decisão: se amanhã você preferir um parágrafo corrido, o resultado esperado é o mesmo.
- O campo 3 pede a palavra de modo e as superfícies. "Photorealistic" sozinho é vago; "poros visíveis e trama do colarinho" é verificável. O guia avisa para tratar especificação de câmera como pista de aparência, não garantia de simulação física: 85 mm ajuda, não obriga.
- Os campos 6 e 7 só existem em edição, porque são o fundamento 6 partido em dois. Em geração do zero não há o que preservar, e "preserve o rosto" sem foto anexada é instrução sem objeto.
- O campo 8 é o que o nosso produto faz por baixo do wizard: o prompt montado diz ao modelo qual imagem é você e quais são material de estilo.
Três prompts prontos para o 2.5, com a razão de cada bloco
Os três estão em inglês porque os exemplos oficiais estão em inglês e a comparação fica mais limpa. Nada impede escrever em pt-BR: o guia não sugere ganho por idioma. Cada um vem com os parâmetros da chamada, porque metade do resultado não está no texto.
Prompt A: gerar um retrato do zero, sem foto de referência
Parâmetros: model="gpt-image-2.5-flare", size="1024x1024", quality="medium", background="auto".
Result: corporate portrait for a professional profile, chest-up, 1:1 square frame.
Subject: a Brazilian professional in their late thirties, seated in a contemporary
São Paulo office with a softly blurred window behind them.
Wardrobe: navy blazer over a light blue shirt, no tie, collar sitting flat.
Light: soft window daylight from camera-left, gentle fill, realistic shadows,
neutral white balance.
Camera: eye-level, 85mm portrait perspective, shallow depth of field.
Attitude: confident and approachable, subtle closed-mouth smile, hands out of frame.
Surface: real editorial corporate photography. Visible skin pores, individual
eyelashes, flyaway hairs, visible fabric weave on the collar, iris texture.
Exclusions: do not beautify, do not smooth skin, do not de-age, no text, no logos,
no watermarks, no badge.
Em pt-BR: retrato corporativo do peito para cima em 1:1, profissional brasileiro perto dos 40 anos em escritório de São Paulo com janela desfocada atrás, blazer marinho sobre camisa azul-clara sem gravata, luz de janela pela esquerda, câmera na altura dos olhos com perspectiva de 85 mm, sorriso contido, superfície de fotografia editorial real com poros, cílios e trama do colarinho, e nada de embelezamento, texto, logotipo ou crachá.
Nota: é o template de oito campos escrito em prosa rotulada, o fundamento 2 em ação. As duas últimas linhas carregam o peso maior porque quality e size são campos da chamada, mas realismo e proibição não são: só a frase controla os dois. Sem a linha de exclusões, a média do treino entrega pele de anúncio de creme.
Prompt B: trocar a roupa preservando a identidade
Parâmetros: model="gpt-image-2.5-sunburst", size="1024x1536", quality="medium", uma a três imagens de referência. Este é o padrão do exemplo oficial chamado "Preserve identity and change clothing", adaptado ao contexto brasileiro.
Edit image 1. Image 1 is the identity reference; image 2 is a clothing reference.
Change only the clothing: replace the current top with a charcoal gray blazer over a
white shirt, no tie, fitted naturally to the existing pose and body geometry, with
realistic fabric behavior and believable collar and shoulder seams.
Do not change the face, facial features, skin tone, body shape, hair, proportions,
pose or identity in any way. Preserve the exact likeness and expression.
Do not change the background, camera angle, framing, lighting direction, color
temperature or image sharpness.
Match the original light and shadows so the garment integrates photorealistically,
without looking pasted on.
Do not add accessories, text, logos or watermarks.
Em pt-BR: edite a imagem 1, que é a referência de identidade, usando a imagem 2 como referência de roupa; mude apenas a roupa por um blazer cinza-grafite sobre camisa branca, ajustado à pose e à geometria do corpo; não altere rosto, traços, tom de pele, cabelo, proporções, pose nem identidade; não altere fundo, ângulo, enquadramento, direção da luz, temperatura de cor nem nitidez; case luz e sombras para a peça não parecer colada.
Nota: o bloco de preservação vem depois do pedido de mudança, de propósito, porque a última instrução é a que o modelo lê mais perto da decisão. E ele nomeia geometria, luz e nitidez, não só o rosto: fundamento 6 à letra. O exemplo oficial é ainda mais explícito, com "Do not change her face, facial features, skin tone, body shape, pose, or identity in any way... Replace only the clothing, fitting the garments naturally to her existing pose and body geometry". A gramática completa dessa trava está em a fórmula da edição cirúrgica.
Prompt C: trocar o fundo preservando rosto, luz e enquadramento
Parâmetros: model="gpt-image-2.5-sunburst", size="1024x1024", quality="medium".
Edit image 1. Change only the background: replace it with a plain, evenly lit
mid-gray studio wall, smooth and free of texture, seams or props.
Keep the subject exactly as they are: face, facial features, skin tone, hair,
expression, head angle, shoulder position, garment and framing are unchanged.
Keep the existing key light direction from camera-left and the existing contact
shadow behind the shoulder, so the subject does not look cut out.
Do not relight the face, do not brighten skin, do not add rim light, do not add a
drop shadow on the wall.
No text, no logos, no watermarks.
Em pt-BR: edite a imagem 1 mudando apenas o fundo, que passa a ser uma parede de estúdio cinza-média, lisa e com luz uniforme; mantenha o sujeito exatamente como está, incluindo rosto, cabelo, expressão, ângulo da cabeça, ombros, roupa e enquadramento; mantenha a luz principal pela esquerda e a sombra de contato atrás do ombro; não reilumine o rosto, não clareie a pele, não acrescente luz de contorno nem sombra na parede.
Nota: a linha da sombra de contato existe porque pedir fundo liso é o gatilho clássico do efeito recorte de montagem. O "do not relight the face" existe porque trocar fundo é o pedido que mais arrasta luz junto, e pele clareada é a primeira coisa que denuncia. Se você quer o prompt já escrito para a sua área, com jaleco, toga ou uniforme, ele está em a biblioteca de prompts por área profissional.
Formato, tamanho, qualidade e fundo são campos, não frases mágicas
A tabela de parâmetros do 2.5 no guia oficial tem quatro linhas: model, quality, size e background. O texto ao redor acrescenta output_compression, válido só para saída JPEG ou WebP, nunca PNG. Tudo isso se resolve num campo da chamada, e repetir no prompt é gastar token pedindo o que já foi configurado.
- Tamanho:
autoou resolução livre no formato LARGURAxALTURA, com quatro restrições. Cada lado no máximo 3.840 px; os dois lados múltiplos de 16; a razão do lado maior para o menor no máximo 3:1; e o total de pixels entre 655.360 e 8.294.400. Exemplos citados na doc: 1024x1024, 1536x1024, 1024x1536, 2048x2048, 2048x1152, 3840x2160 e 2160x3840. - O teto experimental. Saídas acima de 3.686.400 pixels, ou seja, acima de 2560x1440, são declaradas experimentais pela doc. Para foto de perfil é irrelevante: 1024x1024 já cobre o que qualquer rede exibe.
- Qualidade:
auto(padrão),low,medium,high,xhighemax. Os dois últimos são a novidade real da geração 2.5 na API, e o changelog registra exatamente isso: "Both models support the new xhigh and max quality settings". - Fundo:
auto,opaqueoutransparent. Nos dois modelos 2.5 a spec declara suporte a fundo opaco e transparente, enquanto nogpt-image-2a transparência continua marcada como preview. Comtransparento formato de saída tem de ser PNG ou WebP, e é por isso que pedir fundo transparente no texto do prompt não funciona. - Entrada da edição. Cada imagem precisa ser PNG, WebP ou JPG com menos de 50 MB, e cabem até 16 numa chamada. Não é novidade do 2.5: o limite já valia para o
gpt-image-2. - Tamanho do prompt. O teto é de 32.000 caracteres nos modelos GPT image. Não é convite: prompt longo aumenta a chance de instruções se contradizerem, e contradição é o que mais troca rosto.
Um parâmetro merece aviso separado: input_fidelity. A spec da API descreve o campo como suportado no gpt-image-1, no gpt-image-1.5 e em modelos posteriores, o que incluiria o 2.5. Mas a tabela de parâmetros do 2.5 não lista o campo, e a única instrução publicada é para o modelo anterior: "Omit it. Image inputs are always processed at high fidelity." Conferimos a ausência em vez de presumir. Até a doc dizer outra coisa, o caminho seguro é não mandar o parâmetro e não afirmar nada sobre a fidelidade do 2.5.
Rodamos o GPT Image 2.5 contra o GPT Image 2, 24 horas depois do anúncio
Em 09/09/2026, nenhuma página da primeira tela de resultados tinha rodado os modelos. As duas coberturas mais completas declaravam por escrito que não testaram, uma delas com a frase "our live request stopped at API authentication, so we do not claim a successful generation test". No fórum oficial de desenvolvedores, a pergunta em aberto era sobre consumo: o preço por token continuou igual ao do GPT Image 2, mas ninguém sabia quantos tokens os modelos novos consomem. Então medimos.
Método. Nove chamadas reais, mesma conta, mesma janela de cerca de 15 minutos, mesmo ponto de rede. Geração em POST /v1/images/generations com size="1024x1024", quality="low", output_format="webp", n=1 e o mesmo prompt de retrato corporativo de uma persona sintética, sem foto de referência. Edição em POST /v1/images/edits com os mesmos parâmetros, uma imagem de referência de 1024x1024 e um prompt de troca de roupa com bloco de preservação. Cronômetro igual a tempo de parede da requisição HTTP. As imagens são de uma pessoa que não existe, gerada para o teste.
| Chamada | Tempo | Tokens contados pela API | Custo da imagem (USD) |
|---|---|---|---|
| Flare, geração sem referência (N=2) | 11,33 s de média (10,73 s e 11,93 s) | 129 de texto + 196 de imagem de saída = 325 | US$ 0,006525 |
| Sunburst, geração sem referência (N=2) | 12,90 s de média (12,44 s e 13,36 s) | 129 de texto + 196 de imagem de saída = 325 | US$ 0,006525 |
| GPT Image 2, geração sem referência (N=2, controle) | 14,37 s de média (14,05 s e 14,69 s) | 129 de texto + 196 de imagem de saída = 325 | US$ 0,006525 |
| Flare, edição com 1 referência (N=1) | 10,44 s | 100 de texto + 1.024 de imagem de entrada + 196 de saída = 1.320 | US$ 0,014572 |
| Sunburst, edição com 1 referência (N=1) | 14,87 s | 100 de texto + 1.024 de imagem de entrada + 196 de saída = 1.320 | US$ 0,014572 |
| GPT Image 2, edição com 1 referência (N=1, controle) | 14,91 s | 90 de texto + 1.024 de imagem de entrada + 196 de saída = 1.310 | US$ 0,014522 |
Medição própria de 09/09/2026: 1024x1024, quality low, WebP, n=1, mesma conta e mesma janela de 15 minutos. Custo calculado por nós sobre a tabela Standard de preços da OpenAI do mesmo dia.
Três leituras, cada uma com o limite colado.
- Custo por imagem: igual nos três. Nesta configuração os três consumiram os mesmos 196 tokens de imagem de saída e 129 de texto. Preço por token igual mais consumo igual dá custo igual: US$ 0,006525 por imagem. Anexar uma referência de 1024x1024 acrescenta 1.024 tokens de entrada e leva o pedido a US$ 0,014572, ou 2,23 vezes a geração pura. Limite: vale para um ponto da grade. A OpenAI publica que a calculadora do GPT Image 2 não estima o consumo do 2.5, então
xhighemaxnão podem ser deduzidos daqui. - Velocidade: medimos 21,2% a menos de tempo no Flare em geração e 30,0% em edição. O Sunburst mediu 10,2% na geração e empatou na edição, com 0,3%. O anúncio traz dois números com 50%, e eles não são a mesma coisa: a redução de latência de "up to 50%" é do aplicativo contra o Images 2.0, tem "up to" e não fala da API; já a frase sobre a API descreve o Flare entregando "higher-quality images than GPT-Image-2 at 50% lower latency". Essa segunda é a comparável com o nosso teste, e o nosso número ficou bem abaixo dela. Isso não prova que a OpenAI errou. Prova que, no ponto da grade que testamos e que a empresa não especifica, o ganho que sobrou foi esse. As condições da nossa medição, todas elas: N=2 na geração e N=1 na edição,
quality="low", 1024x1024, sem foto de referência na geração, uma única conta, um ponto de rede e uma janela de 15 minutos em 09/09/2026. Latência depende de prompt, referências, dimensão e qualidade, e o próprio guia da OpenAI avisa que ganho medido numa carga não estabelece ganho fixo em outra. Refaça o teste na sua carga antes de decidir com base no nosso número. - A ordem se repetiu em 5 de 5 comparações: Flare, depois Sunburst, depois GPT Image 2. Coerente com a frase do anúncio de que o modelo base tem "longer generation times", que nenhuma outra página oficial repete.
O que a edição realmente preserva
A segunda medição é a mais útil para quem edita retrato. Comparamos pixel a pixel a original de 1024x1024 com cada saída, amostrando um pixel a cada dois em cada eixo e contando como "mudou" todo pixel cujo maior desvio entre os canais vermelho, verde e azul passasse de 10 níveis. O pedido tinha sido explícito: trocar só a roupa, preservando rosto, pose, fundo, ângulo, enquadramento e expressão.
A olho nu funcionou: rosto igual, fundo igual, só o blazer e a camisa mudaram. No número, o quadro inteiro foi redesenhado. Menos de 1% dos pixels voltou idêntico: 0,3% no Flare, 0,4% no Sunburst, 0,6% no gpt-image-2. No retângulo do rosto, de 15,7% a 18,1% dos pixels passaram do limiar visível; no de fundo, 0,1%, o que explica a impressão de que ali nada mudou.
A conclusão é a que a OpenAI publica: "If a region must remain pixel-identical, composite the approved edit into the original image instead of relying on prompting alone." Em pt-BR: se uma região precisa continuar idêntica pixel a pixel, o caminho não é o prompt, é compor a edição aprovada de volta sobre o original. Editar não é alterar um pedaço: é redesenhar o quadro inteiro com quase tudo parecido.
Checklist de migração para quem já usa o GPT Image 2
A OpenAI publica um roteiro de migração em seis passos, e ele é bom. Abaixo está a nossa adaptação para foto profissional, com o teste que fecha cada passo.
- Congele a linha de base. Guarde de 5 a 10 pedidos reais, com prompt, referências,
size,qualityeoutput_format, e as saídas que você aceitou. Sem isso não existe comparação, existe impressão. - Escolha o candidato pela sua dor. Fluxo que já atende: comece pelo Flare, para ver se sobra latência. Fluxo que falha num caso difícil: comece pelo Sunburst, para primeiro provar qualidade.
- Troque uma coisa só, o
model. Prompt, referências, tamanho e formato ficam idênticos na primeira comparação. No nosso repositório essa migração foi literalmente uma linha: a constanteIMAGE_MODELpassou degpt-image-2paragpt-image-2.5-sunburstem 09/09/2026, com endpoint,size,output_formateninalterados. - Confira o resultado inteiro, não a chamada. Cinco perguntas: a identidade sobreviveu? o texto, se houver, está legível? mudou algo que você não pediu? a transparência veio como canal alfa ou como fundo pintado? a sequência inteira de edições aguenta, e não só o primeiro passo?
- Repita o mesmo pedido três vezes. Um acerto isolado não é aprovação. O que você não escreveu é sorteado a cada execução, e a explicação completa está em por que a mesma instrução devolve fotos diferentes.
- Só então mexa em
quality, um degrau por vez.xhighemaxexistem, mas o fornecedor avisa que subir não garante resultado melhor e que o rótulo de qualidade não significa a mesma coisa entre modelos. Meça custo por imagem aceita, não por chamada concluída. E libere por fluxo: o roteiro oficial fecha mandando mover uma fatia pequena do tráfego e manter o modelo anterior disponível para voltar atrás.
Armadilha de contabilidade no passo 6. A página de preços publica duas tabelas com os mesmos nomes de modelo: Standard e Batch. Na Standard, gpt-image-2, Flare e Sunburst estão em US$ 8,00 e US$ 30,00 por milhão. Na Batch, o gpt-image-2 aparece por US$ 4,00 e US$ 15,00, e os modelos 2.5 não aparecem, porque não suportam o endpoint de lote. Ler a coluna errada corta o custo estimado pela metade, e aconteceu na nossa própria tabela interna.
O selo que sai junto com a sua foto
O anúncio diz uma frase curta: "We continue to use C2PA metadata and invisible watermarking to help identify images made with our tools." O system card do ChatGPT Images 2.5 vai além e nomeia a tecnologia: "incorporating watermarking through Google DeepMind's SynthID through ChatGPT, Codex, and the OpenAI API". Nomear a tecnologia importa, e o fato de a camada invisível alcançar a API importa mais para quem gera por código.
Abrimos os bytes dos nove arquivos WebP devolvidos. Em 9 de 9, inclusive nos do gpt-image-2, existe um manifesto C2PA dentro de caixas JUMBF, com claim_generator_info igual a "OpenAI Media Service API", uma asserção c2pa.actions.v2 com action: c2pa.created, o campo digitalSourceType apontando para trainedAlgorithmicMedia e uma ação adicional c2pa.watermarked.unbound. A assinatura é da OpenAI OpCo, LLC, na versão 2.2.0 da especificação.
Três coisas que essa leitura resolve. O manifesto declara que houve marca d'água, mas não nomeia o SynthID: quem nomeia é o system card, e as duas frases não devem ser fundidas. EXIF aparece zero vez nos nove arquivos, então chamar isso de "metadado EXIF de imagem gerada" está errado. E o campo softwareAgent diz name: gpt-image e version: 2.0 mesmo numa chamada ao 2.5: uma medição, um dia, pode mudar amanhã, mas hoje o selo não identifica a versão do modelo.
Nada disso aparece na imagem, e nada disso é novidade do lançamento: o mesmo selo já estava nas saídas do modelo anterior. O enquadramento deste blog continua o mesmo: não existe dever geral de avisar que a foto foi gerada, existe proibição de mentir a procedência, e existe um selo automático que você não controla.
O que ainda não sabemos 24 horas depois do anúncio
Um lançamento de 24 horas produz mais afirmação do que evidência, então vale ser explícito sobre a fronteira do que está medido.
- A nossa medição cobre um ponto da grade. 1024x1024 em
quality="low", geração sem referência e uma edição com uma referência.xhighemaxnão foram medidos, e não podem ser extrapolados. - Não testamos rosto real com referência própria em série. Consistência de identidade por tipo de rosto, tom de pele e tipo de cabelo é onde modelos de imagem historicamente variam, e persona sintética não responde isso.
- Custo por imagem aceita ao longo de semanas continua em aberto. Custo por chamada já sabemos; quantas chamadas até uma foto publicável, só o uso real diz.
- O comportamento pode mudar sem aviso. Snapshot novo é o mecanismo pelo qual o comportamento muda sem o seu código mudar.
Do lado da segurança, o system card publica a avaliação de um conjunto adversarial: o Sunburst gerou com segurança em 77,0% dos casos, bloqueou 21,9% e exibiu conteúdo inseguro em 1,09%; o Flare ficou em 79,4%, 19,2% e 1,41%; o ChatGPT Images 2.0, como linha de base, em 75,2%, 23,1% e 1,64%. O documento avisa nestas palavras que "the numbers below are not representative of how often such prompts arise in production traffic": é um conjunto construído para atacar o sistema, não o uso normal.
O mesmo documento nomeia o risco novo, e ele é o realismo: "ChatGPT Images 2.5 allows for heightened realism that could, absent safeguards, allow more convincing deepfakes, including political, sexual, or otherwise sensitive imagery of real people, places or events". As barreiras rodam no texto e na imagem de entrada, antes de gerar, e a categoria "Other" inclui textualmente "fabricated or compromising depictions of real people". Consequência para quem edita a própria foto: quanto mais realista o motor, mais cedo o bloqueio aparece. O mapa de onde o pedido é recusado e o que fazer então continua valendo.
Perguntas frequentes sobre o GPT Image 2.5
Qual a diferença entre ChatGPT Images 2.5 e GPT Image 2.5?
Preciso pagar para usar o GPT Image 2.5?
O Sunburst é mais caro que o Flare?
Flare ou Sunburst para foto de perfil?
A foto gerada sai com marca d'água?
Testar o Sunburst sem montar uma chamada de API
O fotoslinkedin passou a gerar no gpt-image-2.5-sunburst em 09/09/2026. Em /comecar são três capturas no celular, o seu nome e a expressão que você escolher. A primeira imagem é grátis.
Resumo e próximos passos
Cinco linhas para levar:
- O produto é ChatGPT Images 2.5; a API tem
gpt-image-2.5-flareegpt-image-2.5-sunburst. O ID genérico não existe. - Preço, endpoints, limites de taxa, escada de qualidade e lista de funcionalidades são iguais nos dois. Escolha pela tarefa: Flare para iterar, Sunburst para editar.
- Os oito fundamentos oficiais cabem num bloco de oito campos, e o fundamento 2 diz em letra que o formato do prompt é escolha de legibilidade, não mecanismo.
- Na nossa medição de 09/09/2026, custo por imagem igual nos três modelos no ponto 1024x1024 em
low, e o Flare 21,2% mais rápido na geração. Meça na sua carga antes de decidir. - Editar devolve menos de 1% dos pixels idênticos. Se uma região precisa ficar intacta, componha a edição aprovada de volta sobre o original.
O próximo passo depende de onde você está. Se a dúvida é qual ferramenta usar em vez de escrever chamada de API, o comparativo está em o comparativo entre ferramentas de foto com IA. Se a dúvida é o fluxo completo, do envio da selfie até a foto no perfil, com ética e limites, o pilar é o guia de foto profissional com IA em 2026. Vamos remedir os claims deste artigo em 23/09/2026, quando o rollout tiver acontecido e houver dado de busca para olhar.
Pedro Mota
Fundador, fotoslinkedin.com.br
Pedro Mota é fundador da fotoslinkedin.com.br, ferramenta de IA que transforma uma selfie em foto profissional pronta pro Linkedin em 60 segundos. Antes, atuou com design e produto digital. Hoje vê centenas de fotos por semana e escreve sobre o que funciona pra carreira no Brasil em 2026.