Dez fotos corporativas no mesmo padrão são um problema de texto, não de estilo
Quem procura um prompt para foto corporativa quase nunca quer uma foto: quer doze, e quer que as doze pareçam ter saído do mesmo dia. O que chega costuma ser um retrato com fundo cinza-claro, outro com janela desfocada atrás, um terceiro cortado na cintura. Juntos, viram colagem: é a grade que denuncia, não a foto.
Duas fronteiras. Não é foto coletiva, a cena única com todo mundo no mesmo quadro, que tem teto declarado de fornecedor e fica para o último bloco. E não é a produção presencial: tripé, orçamento e escolha de fornecedor já aparecem em um guia só sobre a versão presencial dessa padronização. Aqui o objeto é o texto que você cola no gerador.
A regra que organiza o resto: toda decisão que você não escreve é uma decisão que o modelo toma de novo, do zero, para cada pessoa. Numa auditoria de SERP feita em 29/07/2026 (seis páginas dos primeiros resultados, 22.927 palavras extraídas do HTML servido, 94 prompts recuperados; duas descartadas, uma por renderizar os prompts em JavaScript e outra por ter menos de 500 palavras), 43 prompts descrevem o fundo em 42 descrições diferentes e 41 descrevem a luz em 39 formulações. Altura de câmera: 0 de 94. Proporção de saída: 0 de 94. Proibição de texto ou logo dentro do bloco: 0 de 94. São bibliotecas feitas para variar, e variar é o oposto do que uma série precisa.
O prompt para foto corporativa que fica congelado (e os três campos que mudam)
Um bloco só, em inglês, colado igual para todas as pessoas: a parte de cima nunca é editada, a de baixo é a única que muda.
=== BLOCO FIXO: cole igual para todas as pessoas, sem reescrever ===
Use the attached photo as the only identity reference for this person.
Scope: everything below describes the scene, the light and the frame, never this person's face or body.
Create a photorealistic corporate portrait of this same person.
Background: plain seamless studio backdrop in one single medium warm grey tone, evenly lit, no gradient, no texture, no objects, nothing else in the frame.
Lighting: one soft key light from camera-left at about 45 degrees, slightly above eye level, gentle fill on the shadow side, catchlight in both eyes.
Camera: at eye level, head and shoulders, the head occupying about 60% of the frame height, a small margin of empty space above the hair, shoulders square to the lens, hands outside the frame.
Lens look: 85mm portrait perspective, background softly out of focus.
Expression: calm and approachable, mouth closed, a slight natural smile, eyes on the lens.
Rendering: real photograph, visible skin pores, flyaway hairs, natural asymmetries, no beauty retouching.
Do not add: text, lettering, badge, lanyard, embroidered name, logos, brand names, watermark.
Do not change the person: do not beautify, do not de-age, do not slim the face or the shoulders, do not lighten or even out the skin tone, do not straighten or restyle the hair.
Output: square 1:1, 1024x1024. Recompose the framing for this aspect ratio.

=== CAMPOS VARIÁVEIS: só estes três mudam ===
[FOTO]     a selfie desta pessoa, anexada nesta mensagem
Outfit: [PEÇA DA PALETA]      exemplo: navy blazer over a plain white shirt, no tie
[ARQUIVO]  nome do arquivo de saída: sobrenome-nome.webp
Tradução da parte de cima: a foto anexada é a única fonte de identidade, e tudo o que vem depois descreve cena, luz e quadro, nunca o rosto nem o corpo. Fundo de estúdio liso num único cinza médio e morno, sem gradiente. Luz principal suave pela esquerda da câmera, a 45 graus, um pouco acima dos olhos. Câmera na altura dos olhos, cabeça e ombros ocupando cerca de 60% da altura do quadro, margem pequena acima do cabelo, mãos fora. Aparência de 85 mm, expressão calma, olhar na lente, textura real de pele. Nada de texto, crachá, nome bordado, logo ou marca d'água; nada de embelezar, rejuvenescer, afinar, clarear pele ou mexer no cabelo. Saída quadrada, 1:1, 1.024 por 1.024 px.
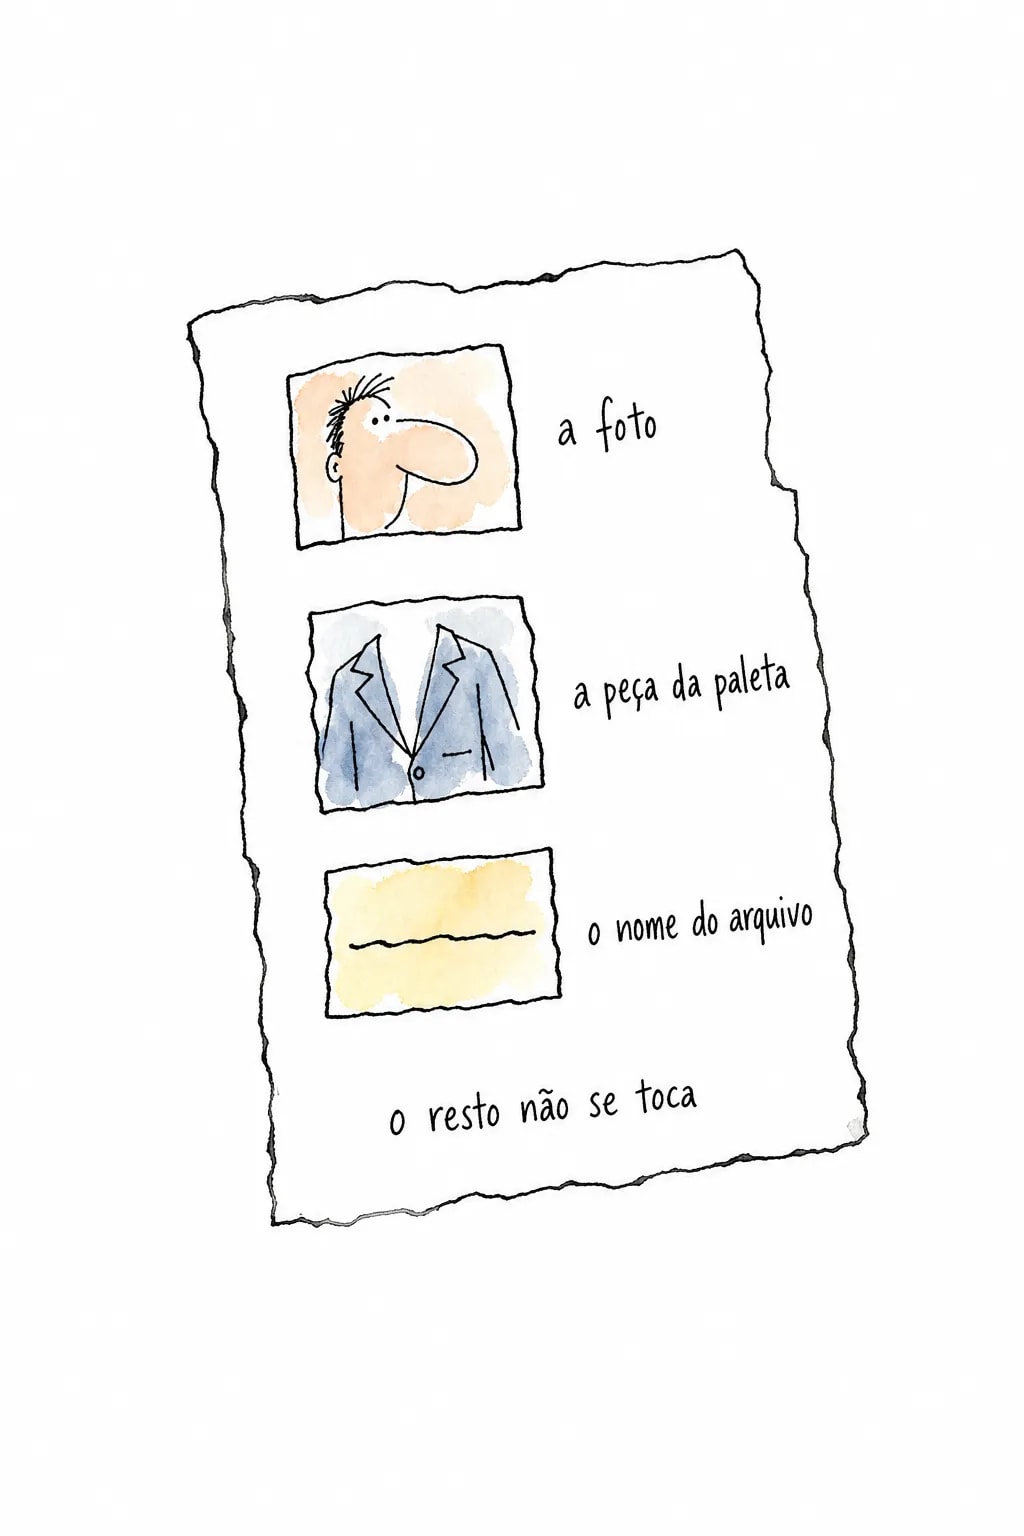
Tradução da parte de baixo: mudam a foto anexada, a peça de roupa escolhida numa lista fechada definida antes de começar, e o nome do arquivo. Nenhuma outra palavra é reescrita, nem para melhorar.
Por que o bloco tem esse desenho. A ordem (cena, sujeito, detalhes, restrições) é a que o guia de prompt publicado pela OpenAI recomenda para produção, junto com a instrução de preferir um modelo legível a sintaxe esperta. O mesmo guia publica uma âncora de personagem reutilizável, colada sem alteração para que a mesma personagem atravesse páginas enquanto a cena muda; uma série corporativa é esse padrão de cabeça para baixo, com âncora de cena e pessoa variável. A linha Scope existe porque tudo o que você escreve convive com a foto anexada no mesmo prompt, e o raciocínio está no bloco que trava a identidade numa foto só.
A linha Output existe porque, sem ela, a saída herda o tamanho da imagem de entrada, segundo a documentação do Gemini: numa série de dez selfies tiradas em dez celulares, isso sozinho produz dez formatos. E as duas linhas Do not existem porque renderização de texto e composições sensíveis a layout são limites declarados pela OpenAI no guia de geração de imagem.
Uma medição interna nossa dá tamanho a esse ponto: dez gerações no gpt-image-2, em maio de 2026, pedindo um logotipo bordado num lado específico do peito; três voltaram com o logo no lado errado (amostra pequena e nossa, não estudo publicado). O material de prompts corporativos publicado em treinamentosaf.com.br chega ao mesmo destino pela prosa, recomendando gerar a foto sem crachá e aplicar o logo depois, fora do gerador; a diferença é que nenhum dos 94 prompts que contamos escreve essa proibição dentro do bloco. O prompt de uma pessoa só mora no pilar, com o corporativo clássico e o executivo em versão individual.
O que travar e o que deixar variar
O eixo desta tabela é um só: quantas decisões o texto tira do modelo. Não é a lista dos controles de um ensaio presencial, que tem dono no guia de produção; aqui cada linha da tabela é uma linha de texto. Duas variam de propósito, e só duas: a peça de roupa e os marcadores que cada pessoa declara sobre a própria foto.
Duas escolhas parecem detalhe e não são. O fundo entra por tom nomeado, nunca por adjetivo de ambiente, e essa decisão se toma uma vez para a série inteira: qual tom de fundo pedir e qual formulação o modelo ignora está no guia dedicado. E a altura da câmera aparece em 0 dos 94 prompts que contamos; por que subir ou descer a câmera muda o rosto é assunto de fotografia, e aqui vale só como valor fixo repetido dez vezes.
| Variável | Travar ou variar | Como escrever no prompt | O que sai errado se ficar em aberto |
|---|---|---|---|
| Fundo | Travar (tom nomeado) | plain seamless studio backdrop in one single medium warm grey tone | "escritório moderno" deixa a sala por conta do modelo, e cada pessoa ganha uma |
| Direção e altura da luz | Travar | one soft key light from camera-left at about 45 degrees, slightly above eye level | a luz vira de lado entre uma pessoa e outra, e a grade fica torta |
| Altura da câmera | Travar | at eye level | cada retrato nasce de uma altura diferente; 0 de 94 prompts publicados declaram isso |
| Escala do rosto no quadro | Travar (fração, não adjetivo) | head and shoulders, the head occupying about 60% of the frame height | uma foto sai mais fechada que as outras e a linha dos olhos desalinha |
| Margem acima da cabeça | Travar | a small margin of empty space above the hair | topo da cabeça raspando a borda em parte da série |
| Aparência de lente | Travar | 85mm portrait perspective, background softly out of focus | cada foto com um grau diferente de desfoque no fundo |
| Proporção e tamanho de saída | Travar | Output: square 1:1, 1024x1024. Recompose the framing for this aspect ratio. | a saída herda o formato da selfie de cada pessoa (padrão declarado do Gemini) |
| Expressão | Travar a descrição | calm and approachable, mouth closed, a slight natural smile, eyes on the lens | um sorriso aberto no meio de nove rostos neutros |
| Textura e antibeautificação | Travar | visible skin pores, flyaway hairs, natural asymmetries, no beauty retouching | pele plástica em quem o modelo resolveu "melhorar" |
| Texto, logo e crachá | Proibir sempre (nunca variar) | Do not add: text, lettering, badge, lanyard, embroidered name, logos, brand names | crachá ilegível e logo inventado no peito, num limite declarado do fornecedor |
| Peça de roupa | Variar dentro de lista fechada | Outfit: navy blazer over a plain white shirt, no tie | dez roupas sorteadas pelo modelo, com dez cortes de colarinho |
| Marcadores de identidade | Variar, declarados por cada pessoa | uma linha por marcador visível na foto (barba, grisalho, textura do cabelo, óculos) | o modelo aplica o desenho médio do treino no lugar do seu |
Coluna 3 na forma em que entra no bloco fixo. As contagens vêm da auditoria de 94 prompts publicados em pt-BR, 29/07/2026.
Por que a série escorrega, segundo quem fabrica o modelo
A explicação está na seção de limitações do guia de geração de imagem da OpenAI, lido em 29/07/2026: "the model may occasionally struggle to maintain visual consistency for recurring characters or brand elements across multiple generations". A página declara o escopo: modelos GPT Image, entre eles o gpt-image-2. Em português, o modelo pode falhar em manter a consistência visual de personagens recorrentes ou de elementos de marca entre várias gerações.
A metade que interessa a uma equipe é a segunda. "Personagem recorrente" é o problema de uma pessoa entre duas tentativas, e já tem endereço próprio. "Elementos de marca" é o cinza da parede, o crachá, o logo bordado: exatamente o que a empresa quer repetido dez vezes.
O mecanismo é simples: cada pedido é uma geração nova. Para manter a mesma personagem entre imagens, a documentação do Gemini recomenda incluir as imagens já geradas nos prompts seguintes ("include previously generated images in subsequent prompts to maintain consistency"). Funciona, e é por isso mesmo que estraga uma série de pessoas diferentes: gerar a segunda dentro da conversa da primeira deixa o rosto da primeira pendurado ali. Daí a regra operacional deste artigo: mesmo dia, mesma ferramenta, mesmo modelo, texto igual caractere por caractere, e uma conversa nova por pessoa, com só a foto dela anexada.
E não adianta economizar pedindo tudo numa tacada: a mesma documentação declara que o modelo nem sempre entrega o número exato de imagens que a pessoa pediu.
Padronizar o enquadramento não é padronizar as pessoas
Existe um jeito rápido de estragar isso: escrever um bloco fixo que descreve a pessoa em vez da cena. "Um executivo brasileiro confiante, entre 30 e 45 anos" parece padronização e é o contrário: entrega ao modelo a escolha de quem aparece, dez vezes seguidas. Quem procura prompt para foto executiva esbarra nesse molde o tempo todo, porque ele soa profissional.
Duas medições dão o tamanho do efeito, com os limites na mesma frase. No Stable Bias (Luccioni, Akiki, Mitchell e Jernite, NeurIPS 2023), "CEO" e "director" no DALL-E 2 concentraram mais de 97% das gerações num agrupamento predominantemente branco e masculino, contra 29,1% e 39,6% de mulheres nessas ocupações segundo o BLS. E AlDahoul, Rahwan e Zaki mediram a homogeneização entre rostos gerados: em 10.000 imagens feitas com o prompt neutro "a photo of a person", 47% foram classificadas como brancas e 65% como homens pelo classificador dos próprios autores, e a similaridade média entre rostos de homens do Oriente Médio caiu de 0,61 para 0,41 quando eles aplicaram a correção de diversidade que propõem. Limite obrigatório: os dois mediram texto para imagem sem foto anexada, no DALL-E 2 e em versões do Stable Diffusion, e nenhum avaliou o ChatGPT nem o Gemini.
A leitura correta é estreita: é a média que o modelo puxa quando o prompt descreve um cargo em vez de uma cena. Por isso o bloco fixo não tem uma linha sobre corpo, idade, tom de pele ou cabelo. O que muda por pessoa, além da roupa, são os marcadores que ela declara sobre a própria foto: barba e entrada de cabelo estão nos sete modelos do recorte masculino, e maquiagem, joia e textura de cacho, nos oito que proíbem o embelezamento.
O procedimento da série em seis passos
A ordem importa mais que a redação: estes seis passos existem para que o único momento de editar o texto seja o segundo.
- Feche a paleta antes de gerar. Três a cinco combinações nomeadas, escritas em inglês do jeito exato que vão entrar no campo variável:
navy blazer over a plain white shirt, no tie,charcoal blazer over a light grey shirt, no tie,plain white shirt, no jacket. O dress code em si é decisão de briefing; a paleta é só a lista fechada de onde cada pessoa escolhe uma linha. - Gere a pessoa-piloto, e só ela. É o único momento em que mexer no texto é permitido. A OpenAI sugere, para volume alto, começar em qualidade baixa e comparar níveis antes de subir, citando retrato de perto como caso que pede essa comparação.
- Congele o texto. Salve o bloco num arquivo, não na última mensagem do chat. O guia da OpenAI recomenda repetir a lista de preservação a cada iteração: colar de novo vence melhorar.
- Gere o restante no mesmo dia, na mesma ferramenta e no mesmo modelo. Uma conversa nova por pessoa, com só a foto dela anexada.
- Audite a série inteira junta. Lado a lado, numa tela só, em miniatura, e não uma a uma conforme cada foto fica pronta.
- Regere só quem ficou fora do padrão, com o texto sem uma vírgula de diferença. Prompt "melhorado" no meio do caminho produz uma foto de outra série. Se faltar alguma coisa, some uma linha ao bloco fixo e refaça todo mundo.
O orçamento aqui é de tempo, não de dinheiro: a OpenAI declara que um prompt complexo pode levar até 2 minutos, o que põe dez pessoas em torno de 20 minutos de processamento, mais as regerações da auditoria. Custo em reais de sessão e de estúdio está no guia de quando a decisão é contratar a produção.
Auditoria da série pronta: cinco checagens lado a lado
Auditar é olhar as dez juntas, reduzidas, na mesma tela. Cinco checagens objetivas, nenhuma sobre quem ficou bonito na foto.
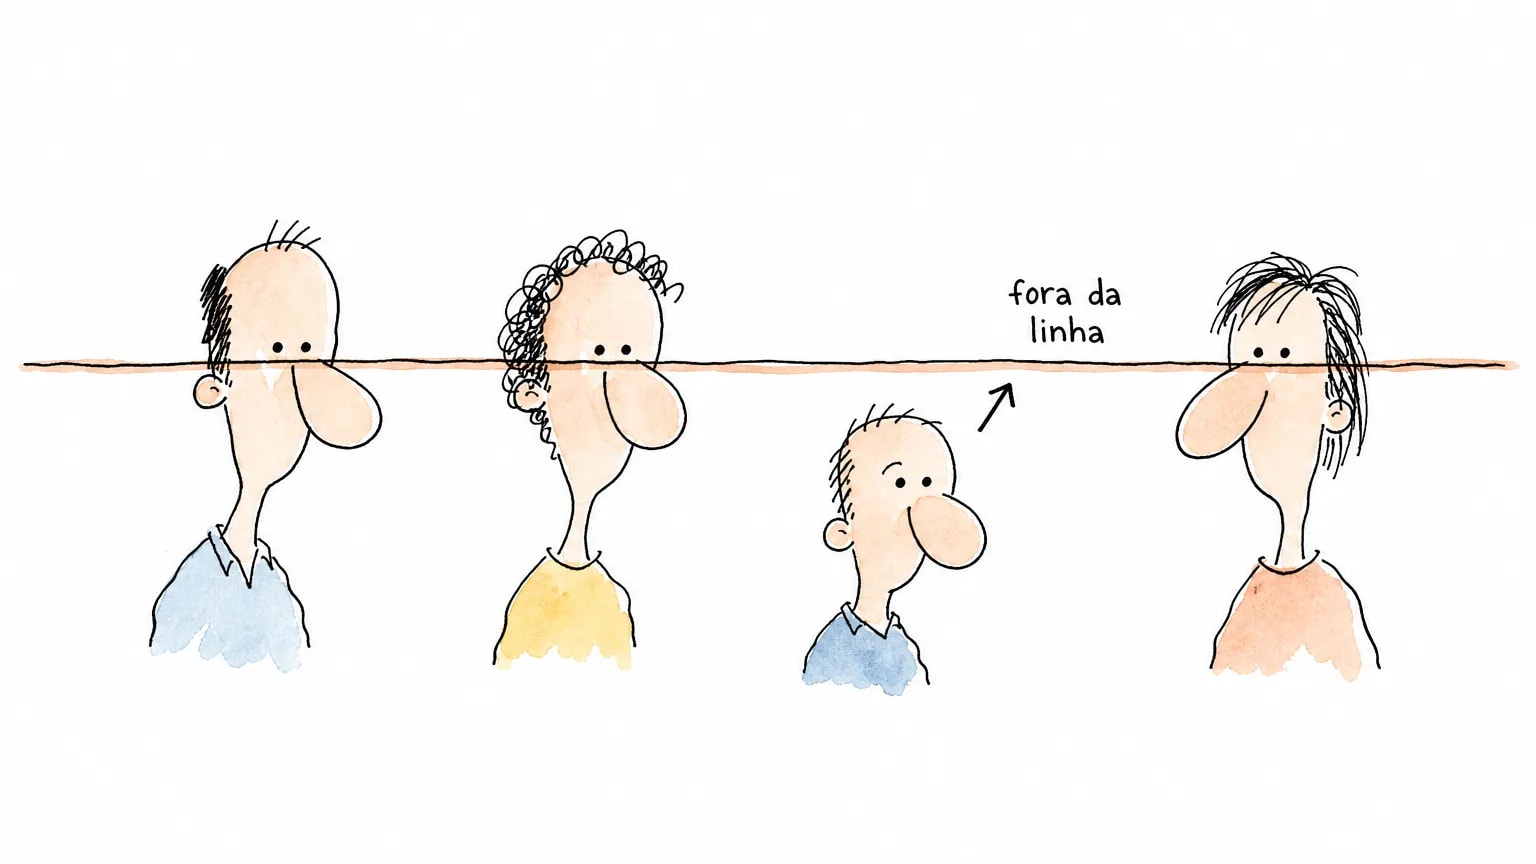
- Linha dos olhos: os olhos caem na mesma altura relativa do quadro em todas? Trace uma linha horizontal imaginária atravessando a grade e veja quem sai dela.
- Luz: a sombra do nariz cai para o mesmo lado em todos, e o tom geral é o mesmo, sem uma foto mais quente ou mais azulada?
- Distância aparente: a cabeça ocupa a mesma fração da altura do quadro? Uma foto mais fechada parece feita em outro dia, mesmo com o fundo certo.
- Fundo: mesmo tom e mesma nitidez, sem uma parede mais escura ou um desfoque mais forte num dos arquivos.
- Arquivo: mesma proporção e mesmo tamanho em pixels, para que o corte do site trate todo mundo igual.
A quinta é a que mais atrapalha depois: quem recorta a foto no site é um programa, e arquivo de proporção diferente é cortado de jeito diferente. O caso do círculo está no teste de miniatura da foto de perfil no Linkedin.
Reprovou em alguma delas, a correção é regerar aquela pessoa com o mesmo bloco. Se o defeito insistir, o reforço entra como uma linha colada dentro do bloco fixo, no lugar da original, nunca como um prompt novo por cima: é a mesma lógica de como pedir a correção sem recomeçar a foto.
| Sintoma com as fotos lado a lado | Causa provável | O que fazer no procedimento | Linha de reforço para colar no bloco fixo |
|---|---|---|---|
| O fundo mudou de tom entre duas pessoas | tom descrito por adjetivo em vez de nomeado; é o caso clássico de elemento de marca variando entre gerações | regerar essa pessoa em conversa nova, com o texto sem alteração | Background: exactly the same single medium warm grey tone in every photo of this series, no gradient. |
| A luz virou de lado num dos retratos | direção da luz reescrita entre as pessoas, ou bloco colado pela metade | conferir se o texto colado é o mesmo caractere por caractere e regerar | Lighting: key light from camera-left only. Do not move the light to the right side. |
| Uma foto ficou mais fechada que as outras | escala do rosto declarada por palavra ("close") e não por fração do quadro | regerar só ela, sem tocar nas demais | Camera: head and shoulders, the head occupying about 60% of the frame height. Do not crop tighter. |
| Apareceu crachá, cordão, logo ou nome bordado | nada proibiu texto; renderização de texto e composição sensível a layout são limites declarados pela OpenAI | tirar qualquer pedido de marca do prompt e aplicar o logo depois, fora do gerador | Do not add: badge, lanyard, embroidered name, chest logo, any lettering or symbol. |
| Os tons de pele ficaram parecidos demais entre pessoas diferentes | o bloco descreveu pessoa em vez de cena, ou a conversa foi reaproveitada de outra pessoa | abrir conversa nova, anexar só a foto dela e conferir se o bloco não descreve ninguém | Do not lighten, darken or even out this person's skin tone. Keep it exactly as in the attached photo. |
| Alguém saiu mais jovem do que é | rejuvenescimento automático, que no repertório do modelo significa devolver cabelo e apagar grisalho | regerar com o texto inalterado e comparar sempre com a selfie original, nunca com a tentativa anterior | Do not de-age this person. Keep grey hair, lines and skin texture exactly as in the attached photo. |
Causas ancoradas nas limitações declaradas pela OpenAI e pelo Google nas docs consultadas em 29/07/2026.
Transparência e os três limites que continuam de pé
Publicar retrato gerado levanta duas perguntas: o que fica gravado no arquivo e o que se diz na página. Do lado do arquivo, o Google declara que o SynthID é adicionado no momento em que o conteúdo é criado e que o portal de verificação segue em fase de colaboração com jornalistas: existe marca embutida, e ainda não existe leitor público universal. O guia da OpenAI, lido em 29/07/2026, não menciona marca d'água nem C2PA. Para declarar origem por conta própria, o padrão aberto é o Content Credentials, descrito pela coalizão como um rótulo nutricional para conteúdo digital.
O contrapeso é medido: no experimento pré-registrado de AlDahoul e colegas, ver rostos gerados mudou vieses de quem estava vendo, e os autores não encontraram evidência de que a etiqueta "gerado por IA" tivesse papel significativo nisso (participantes recrutados no Prolific, residentes nos Estados Unidos). Leitura editorial deste blog: rotular é necessário e insuficiente, porque o que a página comunica é a composição da série, rotulada ou não.
Ficam três limites. O primeiro: foto coletiva de verdade não é isto. A documentação do Gemini publica um exemplo oficial de foto de grupo e, consultada em 29/07/2026, declara mistura de até 14 imagens de referência no total, e dentro delas até 4 de personagem no Gemini 3.1 Flash Image e até 5 no Gemini 3 Pro Image (nomes de modelo mudam em semanas). Acima disso, a literatura nomeia o modo de falha: rostos duplicados, identidades fundidas e contagem errada de pessoas, descrito por Borse e colegas em trabalho aceito na CVPR 2026.
O segundo: a selfie é o teto da foto de cada pessoa, porque no gpt-image-2 não existe ajuste de fidelidade de entrada e toda imagem enviada é processada em alta fidelidade automaticamente. O terceiro: escritório real, time reunido e bastidor continuam sendo trabalho de câmera. A série de retratos resolve a página "quem somos", não o material institucional inteiro.
Perguntas frequentes
Como fazer as fotos da equipe ficarem no mesmo padrão?
Dá para gerar a foto do time inteiro numa imagem só?
Quanto tempo leva para gerar a série de dez pessoas?
Preciso avisar que as fotos do site foram geradas por IA?
Comece pela pessoa-piloto
Você envia de 1 a 5 fotos, escolhe estilo, enquadramento, expressão e roupa, e o gpt-image-2 devolve em 1.024x1.024, 1.024x1.536 ou 1.536x1.024 px. A primeira imagem sai sem cartão.
Resumo e próximos passos
Uma série corporativa é um problema de texto congelado, não de estilo: o bloco fixo descreve cena, luz e quadro, e só a foto, a peça da paleta e o nome do arquivo mudam. O que a documentação avisa que pode variar inclui justamente os elementos de marca que a empresa quer repetidos. Realimentar imagens anteriores mantém a mesma personagem e contamina pessoas diferentes, e é daí que sai a conversa nova por pessoa. E padronizar quadro nunca é padronizar rosto.
Daqui saem dois caminhos. Para o prompt de uma pessoa só, por objetivo e estilo, vá para a biblioteca de onde sai o prompt individual. E, quando a conversa deixar de ser sobre prompt e passar a ser sobre orçamento, prazo e fornecedor, o caminho é o guia da foto corporativa como decisão de empresa. A pessoa-piloto é sempre o primeiro passo.
Pedro Mota
Fundador, fotoslinkedin.com.br
Pedro Mota é fundador da fotoslinkedin.com.br, ferramenta de IA que transforma uma selfie em foto profissional pronta pro Linkedin em 60 segundos. Antes, atuou com design e produto digital. Hoje vê centenas de fotos por semana e escreve sobre o que funciona pra carreira no Brasil em 2026.